26년 10월 4주차 그래프 오마카세
#GUG X AWS Neptune
안녕하세요, GUG입니다.
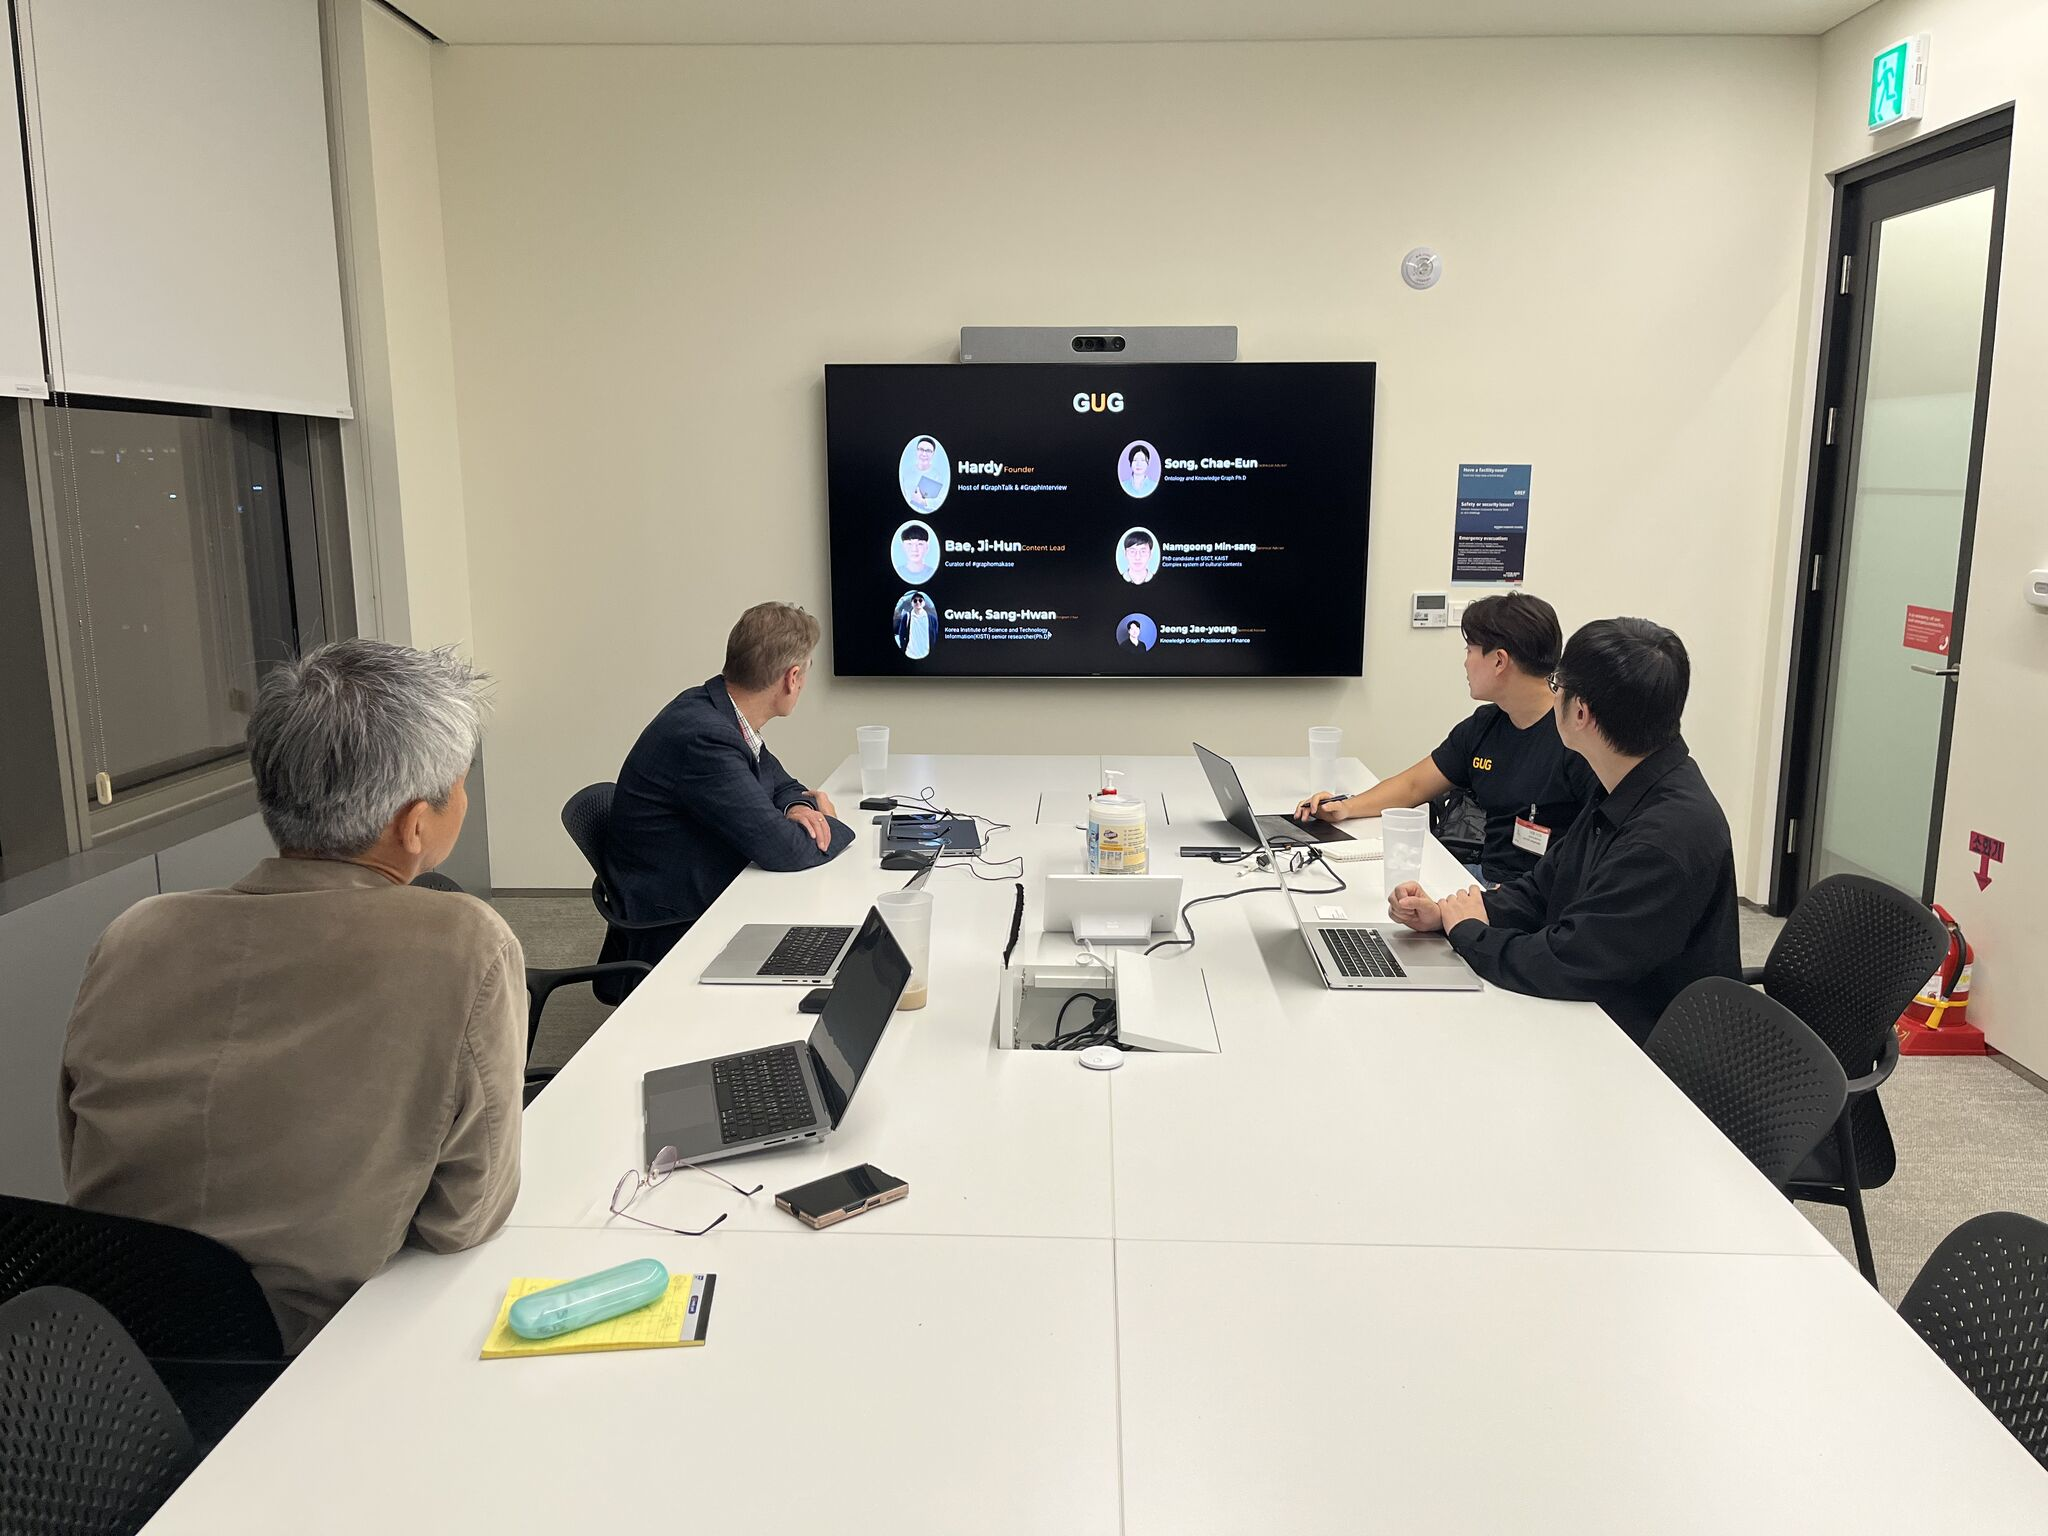
이번주엔 AWS korea Neptune 팀의 초청으로 GUG(Graph User Group) 운영진들과 AWS 간 'Neptune X GUG'를 주제로 깊이 있는 이야기를 나누고 왔습니다. 그간 링크드인을 보며 AWS Neptune에 대해 궁금했던 점들을 속 시원히 해소하고, 향후 로드맵까지 확인할 수 있었던 뜻깊은 시간이었네요.
특히 AWS Neptune 총괄 디렉터인 Brad Bebee와 동석하며 AWS가 그리는 Neptune 큰 그림을 들을 수 있었는데요. 구체적인 내용을 이곳에 모두 공개할 수는 없지만, AWS 플랫폼 전반에 온톨로지(Ontology)를 적극적으로 결합하고 'Ontology Memory'를 활용해 그래프 데이터베이스까지 매끄럽게 연결하려는 시도가 무척 인상적이었습니다.
마침 어제 진행된 ifkakao26'에서도 멀티 에이전트 정렬(Multi-agent alignment)의 한계를 극복하기 위한 미들웨어의 필요성과 시맨틱 레이어(Semantic layer) 기반의 쿼리 세션이 다루어졌습니다.
LLM의 제약 조건(Constraint)을 강제하고 결정론적(Deterministic) 결과를 보장하기 위한 여러 방식이 논의되었는데, 오늘 들은 Neptune의 신규 기능이 추가된다면 이 지점에 Ontology Memory를 개입시켜 문제를 해결하기에 아주 적합하겠다는 직관이 들었습니다.
제가 생각하는 Neptune의 핵심 가치는 단연 '멀티 쿼리 지원(Multi-query support)'입니다. 단일 엔진에서 SPARQL, Gremlin, openCypher를 모두 파싱하고 처리한다는 것은 기술적으로 결코 쉽지 않은 일인데요.
이를 지원하기에 pySHACL이나 pyOWL 등을 활용해 열린 세계 가정(OWA)과 닫힌 세계 가정(CWA)을 모두 아우를 수 있습니다. 나아가 속성 그래프(Property Graph)의 특성을 살리거나 선언적(Declarative) 쿼리 및 정교한 탐색이 필요할 때는 openCypher와 Gremlin까지 유연하게 선택할 수 있어, 워크로드에 맞춰 최적의 도구를 고를 수 있다는 점이 가장 큰 장점이라 생각하네요.
더불어, Bedrock, Aurora 등 기존 AWS 데이터 생태계와의 연동성이 워낙 뛰어나다 보니, 자체적인 데이터 스토리지 및 파이프라인을 구축하며 온톨로지 설계부터 그래프 데이터베이스 운영까지 엔드투엔드로 구현해 보기에 최적의 환경이라는 생각이 듭니다.
말로만 들으면 와닿지않으실거라 생각되기에, 지난 KGC 2026에서 경험했던 AWS 팀의 워크샵 콘텐츠를 GUG 여러분들과 함께 경험하실 수 있게 AWS 쪽과 잘 조율하여 핸즈온 세션을 마련해 보겠습니다. 많은 관심 부탁드립니다!
아울러 국내뿐만 아니라 해외에서도 그래프 기술에 관심 있는 분들 및 기업 연락을 언제든 환영합니다! GUG는 여러분과 함께 지식을 공유하고 커뮤니티를 이끌어갈 준비가 되어 있습니다!
이번주 그래프 오마카세 말미엔 여러분들을 위한 이벤트가 있습니다. 꼭 확인해주세요!
Structural Chain-of-Thought: Reasoning with Executable Computational Graphs
 Petr Senatorov and Karim Vafin and Elena Tutubalina and Oleg Somov
Keywords
- Structural Chain-of-Thought
- Executable and Verifiable Reasoning
- Graph-based GRPO
- LLM의 추론 과정을 단계별로 적게 하는 Chain-of-Thought(CoT)는 이제 기본기가 되었습니다. CoT의 중요한 특징은 사용자가 모델이 결론에 도달하기까지 어떤 단계를 거쳤는지 자연어로 확인할 수 있다는 점입니다.
- 기존 연구에서는 LLM이 올바른 정답을 제시하더라도, 그 앞에 작성한 설명이 정답에 도달한 실제 과정과 일치한다고 보장할 수는 없다는 문제(Faithfulness)가 제기되었습니다. 즉, LLM이 설명한 추론 과정이 실제로 정답을 도출하는 데 사용되었다는 것에 의문을 가지게 되었습니다.
- 또한 추론의 각 단계에서 어떤 연산이 수행되었고, 그 의존성을 명시적인 구조로 표현할 수 없다면 검증하기 어렵고, 추론 과정의 오류를 쉽게 찾아낼 수 없습니다. 따라서 중간 계산의 재실행 문제도 존재하며, 추론 과정이 길어질수록 이를 생성하는데 필요한 토큰 및 연산 비용도 크게 증가합니다.
- 이번 주 오마카세로 소개해드릴 Structural Chain-of-Thought (SCoT으로 약칭)는 LLM이 자연어 생성 대신 계산 그래프 (Executable Computational Graph) 생성을 통해 그래프에 기록된 연산을 실제로 실행하여 최종 정답을 계산할 수 있는 구조화 아이디어를 제안합니다. 그래프의 형식, 정답, 노드 값 일치도를 보상으로 쓰는 강화학습(Graph-Based GRPO)으로 학습하며, 그로부터 중간 계산을 외부 실행기로부터 확인 가능하고 최종 결과가 어떤 계산에 의존하는 것 까지 명시적으로 추적 가능합니다.
- 즉, LLM이 자연어로 유저들의 프롬프트에 맞춰 추론하고 그 결과를 설명하는 방식에서 추론 그 자체를 실행하고 검증 가능한 구조로 생성하는 방식의 전환이 핵심 기여점으로 바라볼 수 있습니다.
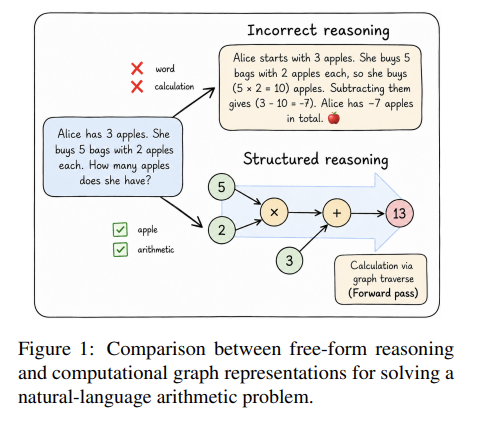
- 기존 CoT에서는 LLM이 프롬프트로 주어진 문제를 해석한 뒤 중간 계산을 자연어로 작성하고, 마지막에 정답을 제시합니다. 이번 논문에서 제안하는 SCoT는 LLM이 추론 과정을 자연어로 설명하는 대신, 그 과정을 실제로 실행할 수 있는 계산 구조로 생성하도록 하자는 것입니다.
- SCoT에서는 DAG (Directed Acyclic Graph) 구조를 사용합니다. 여기에서 각 계산을 독립적인 노드로, 계산에 필요한 값이 어디에서 전달되는지를 엣지로 연결합니다. 그로부터 각 계산이 필요로 하는 입력값 또는 이전 결과에 의존하게 되며, 그래프 방향을 따라 최종 정답에 도달하게 됩니다.
하나의 계산 문제를 두 가지 방식으로 풀어보기
- 어떤 수학 문제를 풀기 위해 일반적인 CoT는 문제에 주어진 정보를 이해한 후 계산하고, 답을 얻어내기 위한 단계 별 과정을 자연어로 설명할 것입니다.
사과가 12개 있고, 3개씩 담긴 상자 2개를 추가로 받았습니다. 이후 사과 5개를 판매했다면 몇 개가 남을까요?
- 위 예시 문제에 대해서, CoT는
3×2=6, 12+6=18, 18−5=13을 문장으로 설명합니다. SCoT는 추가로 받은 사과의 개수 v1 (3 x 2 = 6), 판매 전 전체 사과의 개수 v2 (12 + v1 = 18), 그리고 최종적으로 남은 사과의 개수 v3(v2 - 5 = 13)의 계산 노드로 표현합니다. - 단순히 계산 과정을 세 노드로 나누어 단계화한 것 보다는, 그 노드 간의 연결성을 위주로 살펴보면, v2는 v1의 결과를 입력으로 사용하고, v3는 다시 v2에 의존하게 되는 계산 간 관계가 엣지로 명시된다는 점이 중요합니다.
- 자연어로는 이 관계를 문장 속에서 유저가 직접 읽고 파악해야 한다면, 계산 그래프에서는 이러한 연결관계를 통해 그 의존성을 명시적으로 확인 가능합니다.
실행 가능한 그래프는 어떤 의미인가?
- SCoT가 일반적인 그래프 기반 추론 방식(GoT)과 구별되는 주요 특징은 그래프를 외부 실행기가 실제로 계산하게 된다는 점입니다. 해당 실행기는 그래프의 의존관계를 따라 필요한 연산을 수행하고 최종 결과를 얻습니다. 앞의 예시라면, 먼저 v₁을 계산한 뒤 그 값을 v₂에 전달하고, 마지막으로 v₃을 평가해 13이라는 결과를 산출합니다.
- SCoT는 그래프에 명시된 연산을 실행한 결과를 정답으로 사용할 수 있기 때문에 생성된 그래프에 어떤 연산이 기록되었는지, 필요한 입력이 올바르게 연결되었는지, 실행 결과가 무엇인지를 확인할 수 있습니다. 또한 동일한 입력과 연산이 주어지면 실행 결과도 결정적으로 계산됩니다. 즉, 설명과 정답을 계산하는 절차가 분리되지 않도록 만든다는 점에서 의미가 있습니다.
- 모델의 오류에 대해 실행기는 필터링 없이 그 위에서 계산을 그대로 수행할 수 있기 때문에 계산 그래프가 올바르게 구성되고 실행기가 그 위에서 올바르게 동작하는 것이 반드시 문제에 대한 정확한 해답을 내놓는다는 것은 아닙니다. 즉, 간단히 실행 가능성과 해결 정확성은 서로 다른 조건이라는 것을 염두에 두면 좋겠습니다.
그래프를 사용하는 것 vs 그래프를 실행하는 것
- 그렇다면 기존 Tree-of-Thought(ToT)와 SCoT는 어떤 차이가 있는 것일까?
- 기존의 GoT 연구에서도 하나의 복잡한 문제를 여러 하위 문제로 나누고 서로 다른 추론 경로를 탐색하거나 중간 결과를 결합하는 방법이 제안되어 왔습니다. 이때 그래프는 주로 모델의 사고 과정을 조직하거나 여러 추론 후보 사이의 관계를 관리하는 구조로 활용됩니다.
- SCoT는 그래프의 각 노드를 실행 가능한 계산 단위로 정의하여 모델이 추론을 진행하기 위한 조직 구조인 동시에 최종 결과를 계산하는 역할을 수행합니다. 이렇게 보면 SCoT에서 그래프의 핵심 역할은 LLM 생성 능력과 실행기의 결정능력을 결합하는 접근법으로 이해할 수 있습니다.
- 그렇다면 처음부터 올바른 계산 그래프를 생성하도록 만들 수 있을까?의 질문에 대해 저자들은 그래프의 형식적 유효성, 정답 정확성, 참조 그래프와의 노드값 일치도를 학습신호로 사용해 실행 가능한 추론 구조를 생성하도록 강화학습하는 방법을 제안합니다.
- 위 논문에서 제안하는 핵심 강화학습 방법은 Graph-Based Group Relative Policy Optimization(Graph-GRPO) 입니다. 기존 GRPO 방식이 여러 응답 후보를 생성하고 보상을 비교해 모델을 개선하는 방법이라면 Graph-based GRPO는 그 평가 대상을 실행 가능한 추론 그래프 및 그 계산 과정으로 확장합니다.
- 학습은 크게 두 단계로 진행됩니다.
- Supervised Fine-tuning : 자연어 문제, 정답, 그리고 문제를 해결하는 참조 계산 그래프를 이용해 SFT를 수행합니다. 모델은 이를 통해 어떤 형식으로 노드를 작성해야 하는지, 연산 노드가 다른 노드를 어떻게 참조하는지, 최종 계산 결과를 어떻게 구성해야 하는지 학습합니다.
- Graph-based GRPO : SFT로 학습한 모델에 강화학습을 적용합니다. 하나의 문제에 대해 16개의 후보 그래프를 생성하고, 각 후보의 품질을 보상함수로 평가합니다. 이후 같은 문제에서 생성된 후보들 사이의 상대적인 성과를 이용해, 더 높은 보상을 얻은 그래프가 생성될 가능성을 높이는 방향으로 모델을 업데이트합니다.
- 저자들은 형식에 맞는 그래프를 생성하는 것과 새로운 문제에 필요한 연산을 올바르게 구성하는 것은 서로 다른 문제이며, 최종 정답만 맞히면 높은 보상을 주는 방식은 모델이 중간 계산을 생략하거나 정답을 직접 출력하는 지름길을 학습할 수 있습니다.
- 따라서 저자들은 정답뿐 아니라 그래프 형식과 중간 계산 결과도 함께 평가하도록 보상을 새로 설계합니다.
보상체계 설계
- 수학 문제에 대한 보상으로 세 가지 보상을 사용합니다.
- Style Reward : 모델이 올바른 JSON 구조와 필수 필드를 갖춘 그래프를 생성했는지 평가합니다. 논문에서는 유효한 형식에 +2점, 잘못된 형식에 −2점을 부여합니다. 이는 모델이 자유롭게 계산을 서술하는 대신, 정해진 구조 안에서 계산 노드와 입력 관계를 표현하도록 유도하는 역할을 합니다.
- Correctness Reward : 생성된 그래프를 실제로 실행하고 그 결과를 정답과 비교합니다. 정답이 정확히 일치하면 +3점을 부여하지만, 정답과의 상대적 차이가 작은 경우에도 부분 보상을 제공합니다. 반대로 잘못 계산하거나 실행할 수 없는 그래프에는 감점을 적용합니다.
- Overlap Reward : 저자들은 최종 계산 결과가 맞더라도 중간 추론 과정이 올바르지 않을 수 있다는 점을 고려하여 생성된 그래프의 중간 노드와 참조 그래프 노드 사이에 얼마나 많은 공통점이 있는지 평가합니다. 단순히 정답 하나를 맞히는 것보다 참조 풀이의 중간 계산을 재현하는 그래프가 더 많은 보상을 받을 수 있습니다
- Overlap Reward 보상함수는 주목할 부분입니다. 여기에서 주의할 부분은 그래프의 모든 엣지나 계산 순서가 동일한지 직접 검사하는 방식은 아니기 때문에 중간 노드의 계산값을 비교한다는 점에서 그래프의 완전한 구조적 동일성보다는 중간 계산 내용의 일치도를 평가하는 기준에 가깝습니다.
근거와 연결관계 평가
- 수치 연산문제에서는 중간 계산값이 중요했다면, Entailment와 ProofWriter 같은 수치 연산이 없는 논리 증명 문제에 대해서 어떤 근거를 선택했고 그 근거들을 어떤 순서와 의존관계로 결합했는가가 중요합니다. 이에 맞추어 저자들은 별도의 보상 체계를 적용합니다. 두 평가에는 집합 기반 F1 점수가 사용됩니다.
- Leaves Reward : 모델이 증명에 필요한 전제나 사실을 올바르게 선택했는지 평가합니다.
- Steps Reward : 각 증명 단계가 어떤 사실에 의존하는지를 나타내는 연결관계를 참조 증명 그래프와 비교합니다.
- 이처럼 SCoT는 모든 문제에 동일한 그래프 보상을 적용하는 대신, 추론 대상이 계산인지 증명인지에 따라 그래프에서 검증해야 하는 요소를 구분합니다.
충실도 보상 설계
- Graph-Based GRPO의 중요한 특징은 모델이 정답을 맞혔다는 사실과, 그 정답을 얻기 위해 생성한 추론 구조가 얼마나 적절한지를 함께 학습 신호로 활용한다는 것입니다.
- 따라서 저자들은 후속 실험에서 그래프를 변경했을 때 모델의 답변도 함께 달라지는지 확인하는 Faithfulness 평가를 수행합니다. 여기에서 저자들은 두 가지 보상을 추가합니다.
- Answer Reward : 모델이 직접 출력한 정답이 실제 정답과 일치하는지를 평가합니다.
- Faithfulness Reward :다른 하나는 모델이 직접 출력한 정답과 생성된 그래프를 실행해서 얻은 결과가 서로 일치하는지를 평가합니다.
- 참조 그래프와 계산값이 일치한다고 해서 모델이 그 그래프에 의존해 추론했다는 사실까지 자동으로 증명되지는 않습니다. 이러한 보상은 일반적인 그래프 학습 전체에 항상 적용되는 것이 아니라, 모델이 그래프와 별도로 명시적인 정답을 생성하는 Faithfulness 실험에 추가되는 구성입니다.
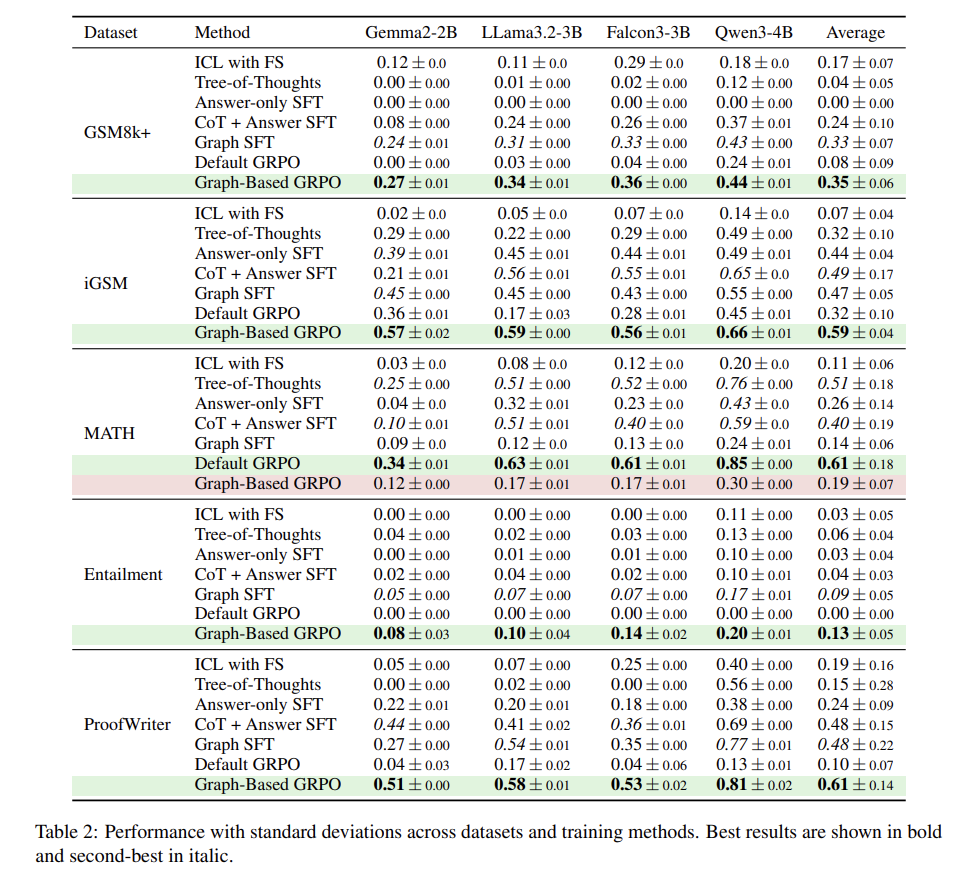
- Graph-based GRPO 학습 방식이 실제로 문제 해결 성능을 높이고, 추론에 필요한 토큰 수 까지 줄이는 효과로 이어졌는지에 대하여, 저자들은 5개의 벤치마크(GSM8K+, iGSM, MATH, Entailment, ProofWriter)와 4개의 언어모델(Gemma2-2B, Llama3.2-3B, Falcon3-3B, Qwen3-4B)을 대상으로 실험을 진행했습니다.
- 해결 성능향상의 관점에서, Graph-Based GRPO는 5개 데이터셋 중 4개에서 비교 방법 가운데 가장 높은 모델 평균 성능을 기록했습니다. 특히 Graph SFT와의 비교는 계산 그래프라는 표현 형식을 학습하는 데서 그치지 않고, 그래프를 평가하는 강화학습까지 적용했을 때 추가적인 성능 향상이 나타날 수 있음을 보여줍니다.
- 하지만 MATH에서는 일반 GRPO 방식이 높은 성능을 기록했습니다. 이는 계산 그래프가 모든 형태의 수학적 추론에 가장 적합한 표현이라는 뜻은 아니라는 점을 보여줍니다. 그래프를 사용하면 항상 더 정확하다는 주장보다는, 실행 가능한 계산 구조를 학습시키는 접근이 여러 추론 과제에서 효과적일 수 있다는 경험적 근거로 확인할 수 있습니다.
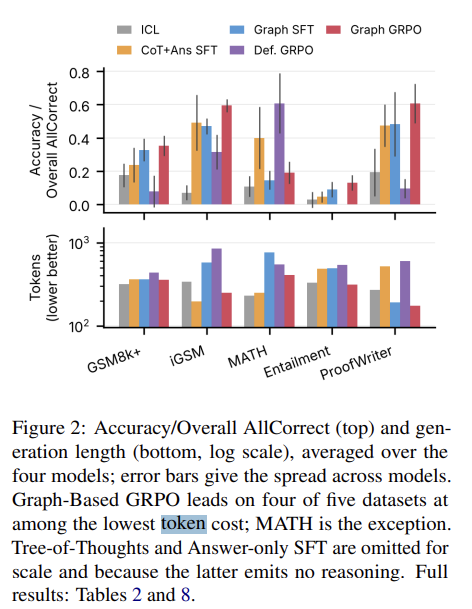
- 흥미로운 결과는 출력 표현의 토큰 효율성에 있습니다. 일반적인 CoT는 중간 계산을 자연어 문장으로 작성하지만, SCoT는 계산 노드의 입력 관계를 명시적으로 표현하므로 자연어의 의존도가 낮습니다. Figure 2에서 보여주듯이, 특정 비교 조건에서 Graph-Based GRPO가 일반 GRPO 또는 CoT 지도학습보다 최대 약 6배 짧은 출력을 생성했음을 보여줍니다.
- 이는 추론을 표현하는 형식 자체를 자연어 설명에서 계산 그래프로 변경하면서, 필요한 정보를 보다 압축적으로 표현할 가능성을 보여준 것입니다. 다만 그래프의 생성뿐 아니라 구조 검사와 외부 실행에 필요한 비용도 존재하기 때문에, 생성 토큰 수가 감소했다고 해서 전체 추론 시간이 같은 비율로 단축되었다고 바라볼 수는 없습니다.
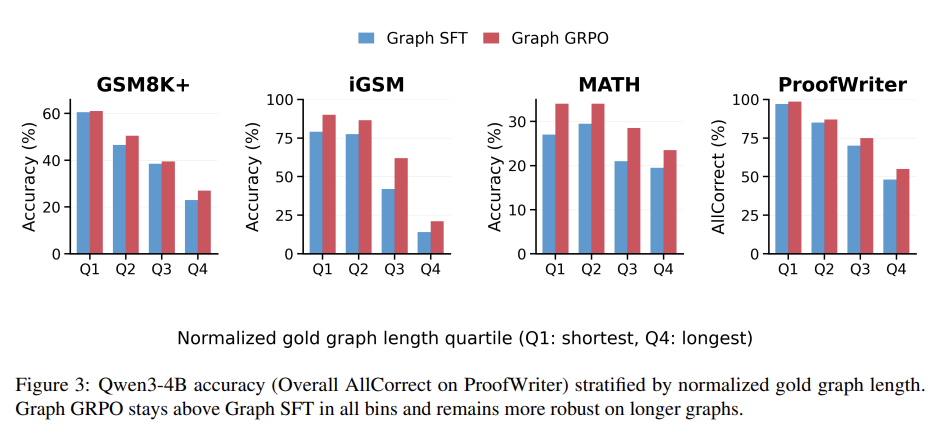
- 더욱 복잡한 문제에 대한 중간 계산이나 증명 단계가 길어져도 SCoT 구조가 도움이 되는지에 대한 결과에서, Figure 3은 Qwen3-4B 모델을 대상으로 네 데이터셋의 성능을 참조 증명 그래프의 길이(참조 그래프의 길이를 정규화)에 따라 비교합니다. 이는 문제 해결에 필요한 구조가 복잡해질 때, 각 연산 사이의 의존관계를 명시적으로 표현하는 계산 그래프의 특성에 기반한 모델 성능이 어떻게 변하는지를 살펴보는 분석을 제공합니다.
- 결과적으로 Graph-Based GRPO는 분석된 모든 길이 구간에서 Graph SFT보다 높은 성능을 보였으며, 상대적으로 긴 그래프를 요구하는 문제에서도 더 좋은 성능을 유지했습니다. 위 결과는 결과는 그래프 기반 강화학습이 단순히 출력 형식을 잘 만드는 데서 그치지 않고, 여러 단계의 의존관계를 구성하는 문제에도 도움이 될 가능성을 보여줍니다.
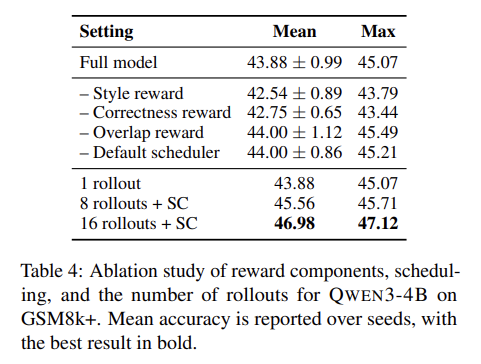
- Ablation study에서 저자들은 다양한 보상함수들을 사용하였을 때 어떤 보상이 실제 결과에 도움이 되었는지를 확인합니다. 평균 정확도는 Table 4에 나와있습니다.
- Style Reward를 제거했을 때는 1.34%p, Correctness Reward를 제거했을 때는 1.13%p의 평균 정확도 감소가 관찰되었습니다. 반면 Overlap Reward를 제거했을 때는 오히려 43.88%에서 44.00%로 소폭 증가했습니다. 적어도 중간 계산값의 일치도를 추가로 보상하는 것이 최종 정답 정확도를 개선했다는 명확한 증거가 나타나지 않았다는 것을 확인해볼 수 있습니다.
- 다음 원인을 곰곰히 생각해보면, 참조 그래프와 비슷한 중간 계산을 만들도록 학습하는 것이 반드시 더 좋은 문제 해결 방법을 학습한다는 의미인건가? 라는 질문이 떠오르실 수 있습니다.
- 직관적으로 한 문제에는 서로 다른 방식의 올바른 풀이가 존재할 수 있기 때문에 참조 그래프와의 유사성을 높이는 목표가 모델의 다양한 계산 경로를 어느 정도 제약할 가능성도 생각해 볼 수 있을 것 같습니다. 다만 해당 결과를 가지고 제안 메커니즘이 실제 원인이라고 결론짓는 것은 어려울 듯 싶습니다.
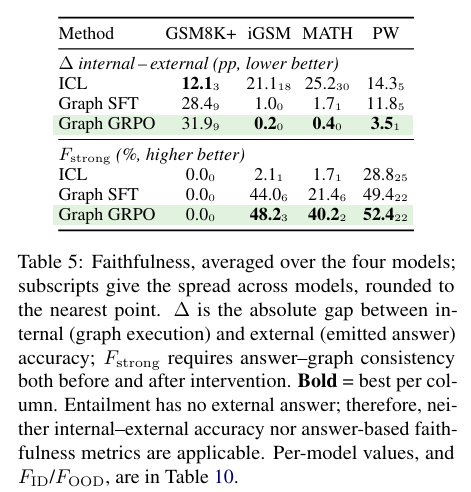
- Table 5에서는 Faithfulness 실험에서는 모델이 별도로 답을 출력하도록 하여, 그래프의 계산 결과와 모델의 직접적인 답변을 비교합니다. 두 정답 경로의 정확도 차이를 Internal–External Accuracy Gap으로 정의합니다.
- 수치적으로 iGSM과 MATH에서는 Graph GRPO를 적용한 뒤 정확도 격차가 각각 0.2pp와 0.4pp까지 감소했습니다. ProofWriter에서도 3.5pp로 감소했습니다. 반면, GSM8K+에서는 Graph GRPO의 격차가 31.9pp로 오히려 가장 크게 나타났습니다.
- 즉, Graph-Based GRPO가 모든 데이터셋에서 두 정답 경로의 정확도를 일치시켰다고 말하기는 어렵습니다. 또한 이러한 정확도 격차만으로 실제 그래프 계산 결과에 답변이 의존하고 있는지는 확인할 수 없습니다.
- 결국 Faithfulness 문제를 완전히 해결한 것 보다, 모델이 생성한 추론을 외부에서 실행할 수 있도록 만들고, 그 추론 구조가 최종 답변에 얼마나 영향을 미치는지를 실험적으로 확인하는 방법을 제시한 점에 의미가 있습니다.
- 그래프가 단순히 사고 과정을 정리한 표현인지, 실제 계산을 수행하는 구조인지, 그리고 모델의 답변이 그 구조에 얼마나 의존하는지를 구분해야 하기 때문에 이러한 구분은 앞으로의 GoT 연구에 중요한 지표가 될 것 같습니다.
- 기존의 CoT가 자연어를 통해 중간 사고 과정을 표현했다면, SCoT는 이를 연산 노드와 의존관계로 구성된 DAG로 생성하고, 그래프를 외부 실행기가 계산하도록 함으로써 중간 연산을 재현하고 최종 정답이 어떤 계산 관계에서 도출되었는지 확인할 수 있게 했습니다. 여기에 Graph-based GRPO를 적용해 정답의 정확성뿐 아니라 그래프의 형식과 중간 계산까지 학습 신호로 활용했다는 점도 주목할 만합니다. 실험에서도 여러 의미 있는 결과가 확인되었습니다.
- 하지만 일부 문제에서는 좋은 성능을 보이지 못했으며, Ablation 실험을 통해서도 중간 계산의 일치도를 평가하는 Overlap Reward 역시 모든 설정에서 추가적인 정확도 향상을 보여주지는 못한 한계점도 존재합니다. Limitation 세션에서도 추가적으로 추론 과정을 계산 그래프 형태로 자연스럽게 표현할 수 있는 과제들에만 적용 가능하다는 한계도 있음을 밝히고 있습니다.
- 위 논문을 읽으면서 가장 흥미로웠던 인사이트를 공유드려보면, 그래프를 활용해 LLM의 추론 과정을 더 복잡하게 만드는 것이 아니라, 보다 명시적이고 검증 가능한 계산 구조로 바꾸려 했다는 것입니다. 특히 기존 ToT, GoT 등의 흐름이 여러 추론 후보를 탐색하고 조합하는 구조에 주목했다면, 이번 연구는 그래프 자체를 실행 가능한 계산 표현으로 사용한다는 점에서 차별화된 기여를 보여주었다고 생각합니다.
SCoT의 핵심은 모델이 내놓은 답변을 따라가는 과정에서, 일차원적 추론의 정확성 및 효율성을 개선 가능할 뿐 아니라, 실제로 실행 가능하고 검증 가능할 수 있는지까지 함께 고민할 수 있는 접근법을 제시하였습니다. 그리고 그 질문을 그래프를 통해 구체적으로 탐색하여 흥미로운 결과를 보여주었습니다.
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184
GUG가 이번 NVIDIA AI DAY의 국내 파트너 커뮤니티 중 하나로 선정되어, 멤버분들을 위한 사전 참석 티켓을 확보했습니다. 행사 참석을 희망하시는 분은 graphusergroup@gmail.com 으로 신청 의사를 남겨주시기 바랍니다.
*배포 안내: 신청 인원이 준비된 티켓 수량을 초과할 경우, 커뮤니티 내 활동 기여도가 높으신 분을 우선하여 선착순으로 전달드릴 예정입니다.
관심 있는 분들의 많은 참여 바랍니다.