26년 9월 1주차 그래프 오마카세
Graph to Frame RAG: Visual-Space Knowledge Fusion for Training-Free and Auditable Video Reasoning
Graph-to-Frame RAG: Visual-Space Knowledge Fusion for Training-Free and Auditable Video Reasoning
When video reasoning requires external knowledge, many systems with large multimodal models (LMMs) adopt retrieval augmentation to supply the missing context. Appending textual or multi-clip evidence, however, forces heterogeneous signals into a single attention space. We observe diluted attention and higher cognitive load even on non-long videos. The bottleneck is not only what to retrieve but how to represent and fuse external knowledge with the video backbone.We present Graph-to-Frame RAG (G2F-RAG), a training free and auditable paradigm that delivers knowledge in the visual space. On the offline stage, an agent builds a problem-agnostic video knowledge graph that integrates entities, events, spatial relations, and linked world knowledge. On the online stage, a hierarchical multi-agent controller decides whether external knowledge is needed, retrieves a minimal sufficient subgraph, and renders it as a single reasoning frame appended to the video. LMMs then perform joint reasoning in a unified visual domain. This design reduces cognitive load and leaves an explicit, inspectable evidence trail.G2F-RAG is plug-and-play across backbones and scales. It yields consistent gains on diverse public benchmarks, with larger improvements in knowledge-intensive settings. Ablations further confirm that knowledge representation and delivery matter. G2F-RAG reframes retrieval as visual space knowledge fusion for robust and interpretable video reasoning.
 Songyuan Yang
- 최근의 비디오 이해 모델은 영상 속 객체나 행동을 인식하는 것을 넘어, 여러 장면을 연결해 사건의 원인이나 맥락을 추론하는 방향으로 발전하고 있습니다. 하지만 영상에 직접 나타나지 않는 상식이나 배경지식까지 필요해지면, 모델이 영상만 보고 답하기에는 한계가 생깁니다.
- Video RAG(Video Retrieval-Augmented Generation)는 이런 부족한 정보를 외부에서 검색해 영상 모델의 추론을 보완하는 접근입니다. 초기에는 자막이나 설명 텍스트를 프롬프트에 덧붙이는 방식(Text-Append RAG)이 주로 활용되었고, 이후 관련 keyframe을 추가하거나, 최근에는 문서와 이벤트를 그래프로 구조화해 필요한 부분만 선별적으로 전달하는 방식(GraphRAG)까지 다양하게 발전해왔습니다.
- 이번 주 오마카세에서 전달해드릴 논문에서는 다음 방법의 핵심 문제점을 제기합니다. 외부 정보를 추가하면 당연히 추론에 도움이 될 것 같지만, 영상이 그렇게 길지 않은 경우에도 검색한 정보를 덧붙이는 순간 오히려 성능이 떨어지는 사례가 반복적으로 관찰된다는 것입니다.
- 저자들이 핵심 문제로 지목하는 것은 Attention competition입니다. 연속적인 저수준 시각 신호와 이산적인 고수준 텍스트가 하나의 어텐션 공간 안에서 계속 자리를 다투게 되고, 모델은 두 개의 서로 다른 표현 방식 사이를 번갈아 오가야 한다는 것입니다. 저자들의 분석에서는 그 결과 핵심 프레임에 대한 주의가 분산되는 패턴이 관찰되며, 이를 표현 방식 간 경쟁으로 인해 추론 부담이 커질 수 있다고 해석합니다.
- 해당 논문에서 제안하는 G2F-RAG (Graph-to-Frame RAG)는 검색한 지식을 어떻게 표현하고 영상과 융합할 것인가를 문제의 중심으로 끌어오고, 그 답으로 텍스트가 아니라 한 장의 그래프 렌더링 프레임을 제안합니다. 지식 그래프로 정리한 정보를 이미지 한 장으로 압축해 영상의 마지막 프레임처럼 붙여버리면, 모델은 익숙한 시각 추론 공간 안에서 검색 결과까지 함께 처리할 수 있다는 아이디어입니다.
- 논문 제목에서도 알 수 있듯이, 추가적인 백본 학습 없이 기존 비디오 모델에 적용할 수 있다는 것입니다. 어떤 그래프 정보가 선택되었고 그것이 최종적으로 어떤 프레임으로 변환되었는지가 중간 결과로 남기 때문에, 검색과 추론 과정을 추적·검토할 수 있는 구조라는 점도 실용적인 장점으로 볼 수 있습니다.
기존 Video RAG의 어텐션 분석
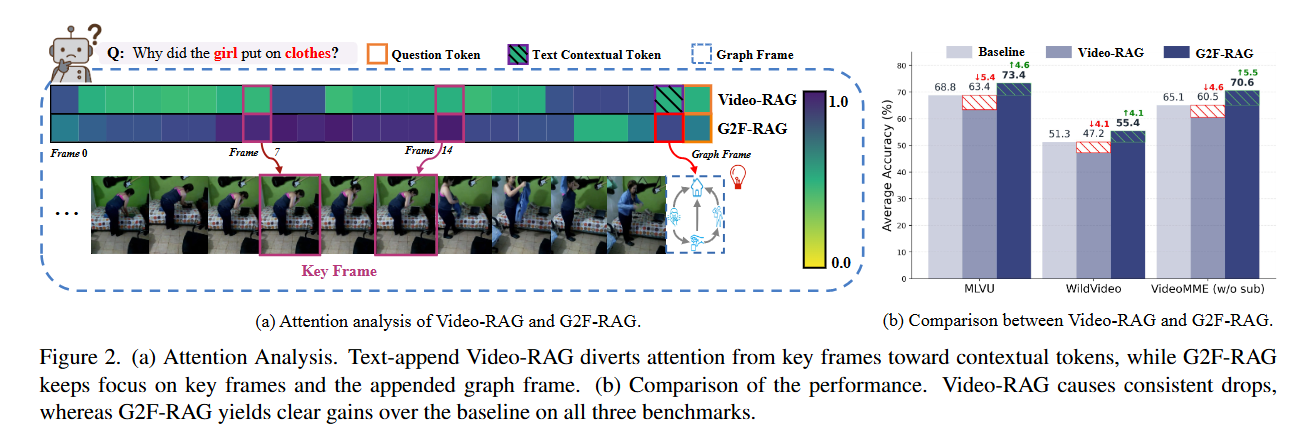
- G2F-RAG의 방법론을 설명하기에 앞서, 저자들은 먼저 기존 Video RAG에서 성능 저하와 함께 어떤 어텐션 변화가 나타나는지를 측정하고 분석합니다. Qwen2.5-VL을 백본으로 두고 프레임별 어텐션 스코어를 모든 헤드에 걸쳐 집계한 뒤, query 토큰과 검색된 컨텍스트 토큰에 대한 어텐션 분포를 구분해 비교합니다.
- 본문의 Figure 2는 텍스트 형태로 검색 정보를 전달할 때와 그래프 프레임으로 전달할 때의 어텐션 차이를 보여줍니다. 왼쪽의 (a)는 동일한 Qwen2.5-VL 백본에서 두 방식의 어텐션 분포를 비교하고, 오른쪽은 MLVU, WildVideo, VideoMME 세 벤치마크에서의 성능 변화를 함께 보여줍니다.
- 텍스트 기반 Video-RAG에서는 어텐션이 길게 늘어난 검색 컨텍스트와 상대적으로 중요하지 않은 프레임으로 분산되는 반면, G2F-RAG에서는 질문과 관련된 핵심 프레임과 영상 끝에 추가된 그래프 프레임을 중심으로 어텐션이 집중되는 패턴이 관찰됩니다. 이러한 차이는 해당 실험 설정에서의 성능 변화와도 함께 나타납니다.
- 이 경향은 수치에서도 그대로 나타납니다. MLVU(Multi-task Long Video Understanding)에서 Video-RAG는 기준선 대비 5.4점 떨어지는 반면 G2F-RAG는 4.6점 올랐고, WildVideo에서는 각각 4.1점 하락과 3.9점 상승, VideoMME에서는 4.6점 하락과 5.5점 상승하였습니다.
- 여기서 저자들이 전달하는 핵심 메시지는 명확합니다. 동일한 백본과 검색 정보를 사용하더라도, 그 정보를 어떤 형태로 전달하느냐에 따라 성능의 방향 자체가 달라질 수 있다는 것입니다. 검색 자체뿐 아니라 검색된 지식의 표현과 전달 방식이 별도의 설계 문제다라는 관점을 중심에 두면 G2F-RAG의 아이디어를 보다 쉽게 이해할 수 있습니다.
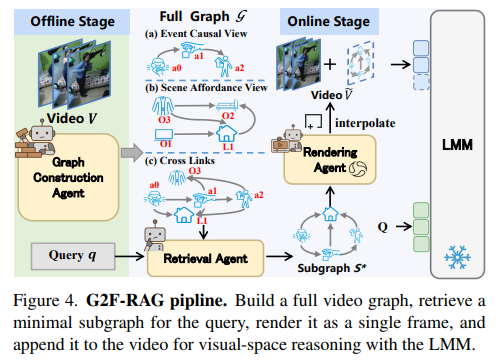
- G2F-RAG의 전체 파이프라인은 크게 2단계 (오프라인 & 온라인)으로 구성됩니다. 오프라인에서는 영상별 전체 지식 그래프를 미리 구축하고, 실제 질문이 들어오는 온라인 단계에서는 필요한 정보를 검색한 뒤 이를 그래프 프레임으로 변환해 최종 추론에 활용합니다.
- 조금 더 세분화하면 다음과 같습니다.
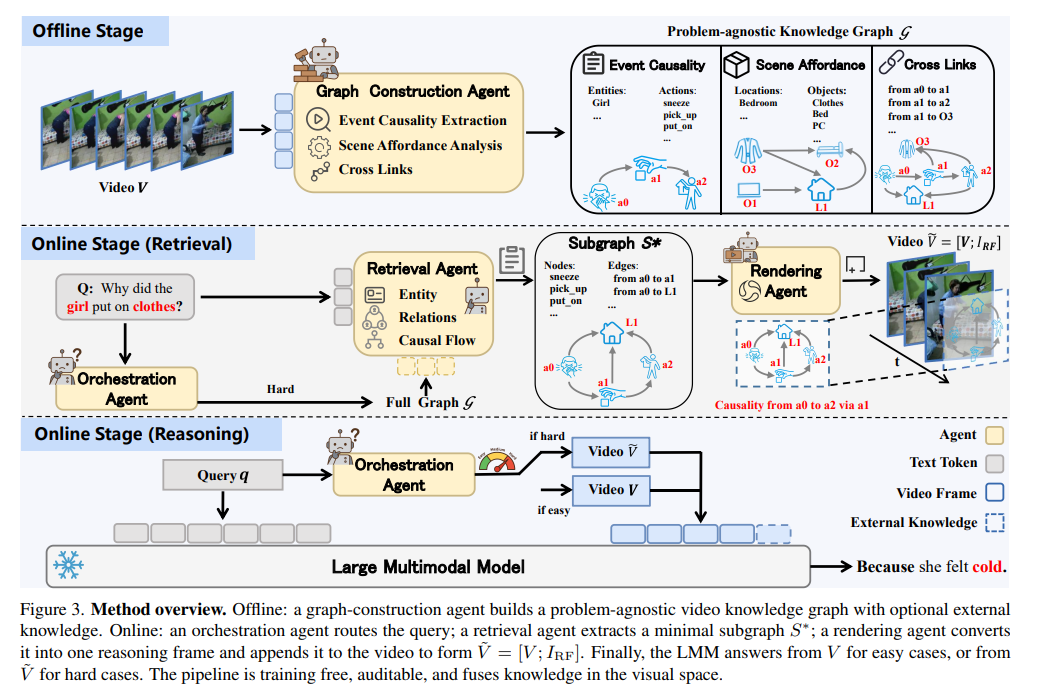
- 오프라인 — 지식 그래프 구축 : 비디오를 분석해 객체·행동·이벤트·장면 정보를 추출하고, 이를 Event-Causal View와 Scene-Affordance View로 구조화합니다. 이후 두 관점을 cross-link로 연결해, 다양한 질문에 재사용할 수 있는 하나의 전체 지식 그래프를 구축합니다.
- 온라인 — 라우팅과 검색 : 먼저 입력된 query에 그래프 증강이 필요한지를 판단합니다. 원본 영상만으로 충분한 질문은 곧바로 기본 경로로 보내고, 추가적인 지식이 필요한 질문에 대해서만 전체 그래프에서 관련 서브그래프를 검색합니다. 이 과정은 뒤에서 살펴볼 여러 에이전트의 역할 분담을 통해 이루어집니다.
- 온라인 — 렌더링과 추론 : 검색된 서브그래프를 한 장의 그래프 프레임으로 렌더링해 영상의 마지막에 추가합니다. 최종 비디오 모델은 원본 영상과 이 프레임을 함께 입력받아, 검색된 지식을 긴 텍스트가 아니라 시각적 표현의 형태로 참조하며 답을 추론합니다.
오프라인 — Problem-Agnostic 지식 그래프 구축
- 먼저 오프라인 단계에서는 그래프 구성 에이전트가 각 영상에 대해 특정 질문에 종속되지 않는 전체 지식 그래프를 한 번 구축해 캐싱합니다. 이후 서로 다른 질문이 들어오더라도 매번 그래프를 새로 만들 필요 없이, 이 전체 그래프에서 필요한 부분만 검색해 활용할 수 있습니다.
- 전체 그래프는 크게 두 가지 관점을 결합해 구성됩니다
- Event-Causal View : 등장인물의 행동과 의도, 사건의 전제·결과 조건, 그리고 사건 사이의 인과적 연결 관계를 표현합니다.
- Scene-Affordance View : 장면에 등장하는 사물과 그 기능, 공간적 연결 관계, 그리고 사물과 관련된 개념적 지식 등을 표현합니다.
- Cross-link – 두 view를 연결 :어떤 사건이 일어났는가라는 시간적·인과적 정보와, 그 사건이 어디에서 어떤 사물과 함께 일어났는가라는 공간적 & 기능적 정보를 하나의 그래프 안에서 함께 탐색할 수 있도록 설계했습니다.
온라인 — 난이도 라우팅과 최소 서브그래프 검색
- 온라인 단계에서는 세 종류의 에이전트가 순차적으로 역할을 나눠 수행합니다. 먼저 그래프 증강이 필요한지를 판단하고, 필요한 경우 질의와 관련된 최소 서브그래프를 검색한 뒤, 이를 하나의 reasoning frame으로 렌더링하는 구조입니다.
- Orchestration Agent : 입력 query를 easy / hard로 라우팅합니다. easy로 판단된 질문은 원본 영상만으로 바로 답하게 해 불필요한 증강을 피하고, hard로 판단된 경우에만 G2F-RAG 경로로 보냅니다.
- 저자들은 이러한 판단을 임계값 (τ)를 기준으로, 그래프 증강을 사용했을 때 기대되는 효용과 원본 영상만 사용할 때의 기대 효용 사이의 차이로 표현합니다. 그래프 지식을 추가했을 때 예상되는 이득이 τ 이상인 경우에만 RAG path를 선택합니다.
- 실제 구현에서는 GPT-4o-mini 기반 에이전트가 영상 내부에서 근거를 얼마나 쉽게 찾을 수 있는지, 추론 단계가 얼마나 길어질 것으로 예상되는지 등을 프롬프트를 통해 판단합니다
- Orchestration Agent : 입력 query를 easy / hard로 라우팅합니다. easy로 판단된 질문은 원본 영상만으로 바로 답하게 해 불필요한 증강을 피하고, hard로 판단된 경우에만 G2F-RAG 경로로 보냅니다.
- 수식 2, 3은 별도의 학습된 router나 utility model이 값을 정밀하게 계산한다는 의미라기보다, 이러한 라우팅 원칙을 형식적으로 정리한 개념적 표현에 가깝습니다.
- Retrieval Agent : 전체 그래프에서 관련성과 복잡도 패널티를 함께 고려하여, 질의에 충분한 정보는 남기되 불필요한 노드와의 관계는 줄인 최소 서브그래프 (S*, 수식 1 참고)를 선택합니다.
- 이때 이후의 렌더링 단계에서 한 장의 프레임이 지나치게 복잡해지는 것을 막기 위해, 선택되는 서브그래프에는 명시적인 visual budget (노드 : |V(S*)| ≤ Nmax / 엣지 : |E(S*)| ≤ Emax)을 둡니다.
- 질문에 필요한 정보만 남기면서, 한 장의 그림으로 표현 가능한 수준까지 복잡도를 제어한다는 원칙이 적용되는 셈입니다.
- Rendering Agent : 이렇게 고른 S*를 해당 에이전트가 하나의 reasoning frame (I_RF)로 바꾸고, Graphviz로 아이콘과 짧은 라벨 위주의 단일 프레임으로 그려내고, 이를 영상의 마지막 프레임(\tilde V = [V; I_RF])으로 이어붙입니다.
- 원본 영상의 시간적 흐름 한가운데에 개입하지 않으면서도, temporal attention이 마지막 그래프 프레임까지 자연스럽게 참조할 수 있도록 하기 위해서 프레임을 제일 마지막에 붙이는 것이 중요한 설계 선택임을 밝힙니다. 이후 ablation을 통해 프레임의 위치와 개수에 따른 성능 차이도 비교합니다.
- 또한 I_RF에는 별도의 시간 구간이나 타임스탬프를 추가하기보다, 검색된 사건과 객체 사이의 구조적·인과적 관계를 간결하게 보여주는 데 집중합니다.
- 결국 G2F-RAG가 바꾸는 것은 백본 자체가 아니라, 검색된 지식을 어떤 형태로 압축하고 전달할 것인가라는 입력 표현 방식입니다.
Case Study ㅡ G2F-RAG의 실제 동작 흐름
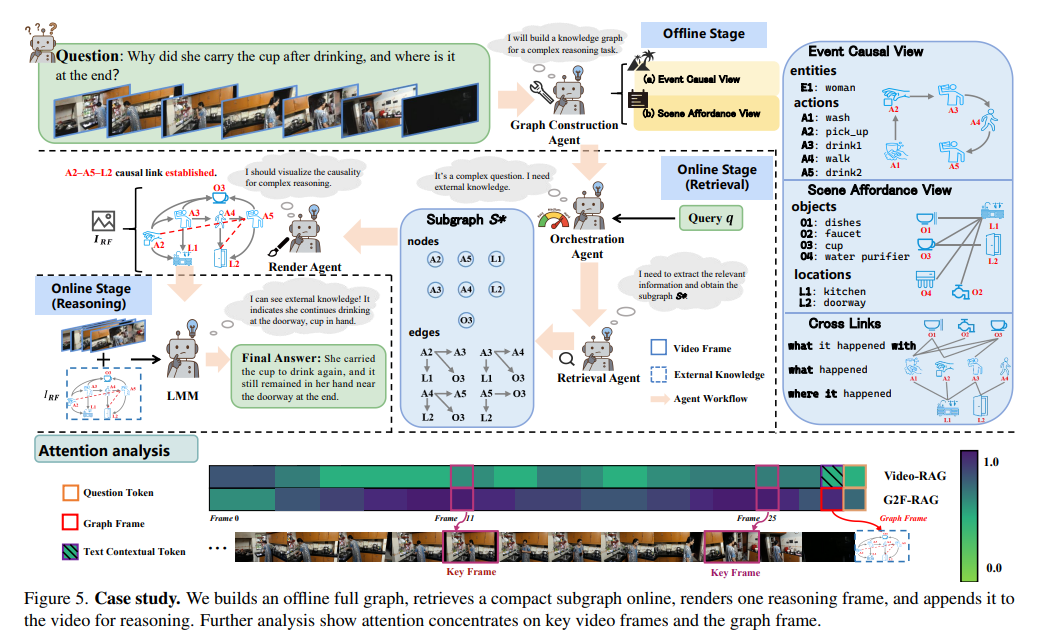
- Figure 5에서는 앞서 Figure 3에서 살펴본 추상적인 G2F-RAG 파이프라인을 하나의 실제 질문을 통해 구체화합니다.
- "한 여성이 컵을 들고 이동한 이유와 마지막 위치?"의 질문에 대해서, 오프라인 full graph가 행동, 사물, 장소를 담고, orchestrator가 hard로 판단한 뒤 pick-up – drink – walk – drink와 doorway, cup을 연결한 최소 서브그래프 S*를 검색하여 이를 reasoning frame으로 렌더링하고 원본 영상의 뒤에 추가합니다.
- 하단의 attention visualization에서도 모델의 주의가 질문과 관련된 핵심 프레임들과 마지막 그래프 프레임을 중심으로 형성되는 패턴을 확인할 수 있습니다.
- S의 의미도 조금 직관적으로 이해할 수 있습니다. 즉 S*는 full graph를 단순히 작게 축소한 버전이 아니라, 현재 질문에 답하는 데 필요한 인과적 &공간적 연결만 선택적으로 남긴 minimal sufficient subgraph에 가깝습니다.
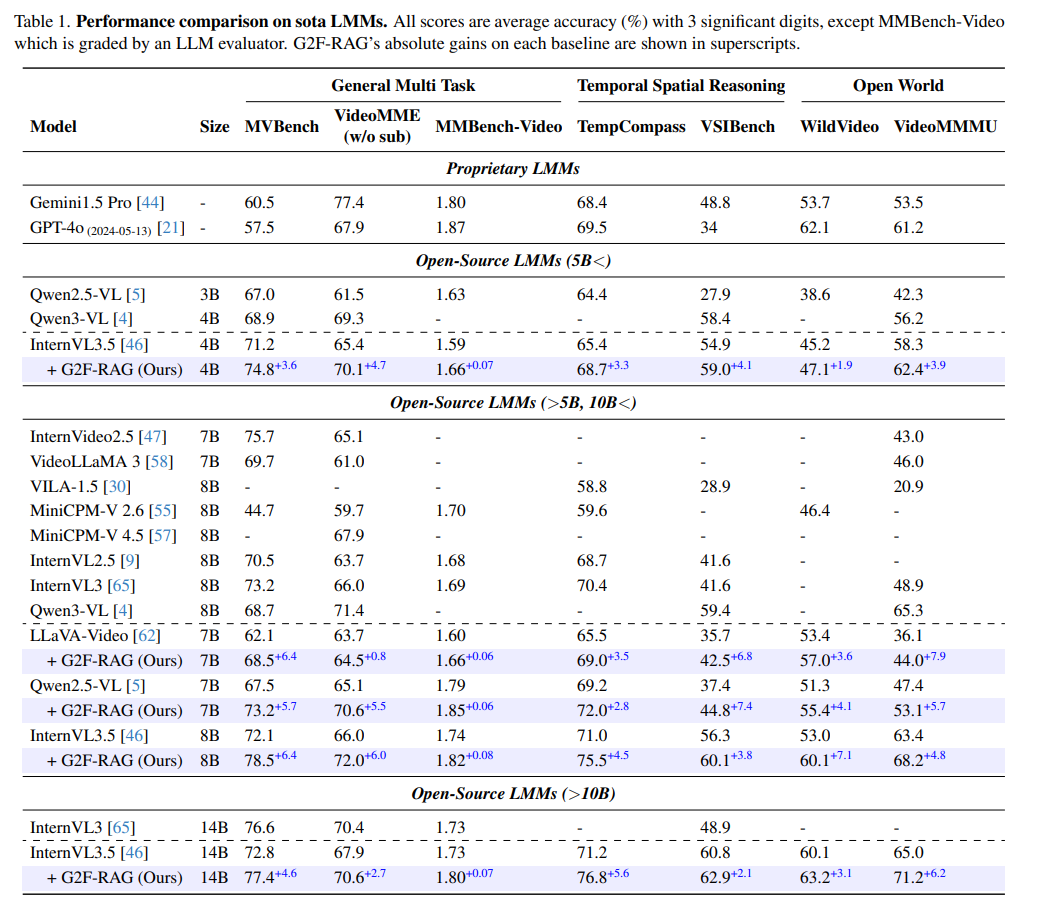
- InternVL3.5, LLaVA-Video, Qwen2.5-VL 등 서로 다른 백본과 4B~14B의 모델 규모 전반에서 G2F-RAG의 성능 개선이 관찰됩니다. 특히 4B·7B급 소형·중형 모델에서는 여러 벤치마크에서 3~7점대의 비교적 큰 개선이 자주 나타나며, 14B 규모에서도 그 효과가 유지됩니다.
- 이러한 결과에 대해서, 저자들은 Graph-to-Frame 방식의 효과가 특정 모델이나 모델 규모에 국한되지 않고, 서로 다른 아키텍처에서도 비교적 일관되게 전달될 수 있다는 근거로 해석합니다.
- 즉, 단순히 모델의 파라미터 수가 커서 얻는 이득이라기보다, 검색된 지식을 시각 프레임으로 변환해 비디오 모델이 활용하기 쉬운 형태로 전달하는 방식 자체가 여러 백본에서 유효하게 작동한다는 것입니다.
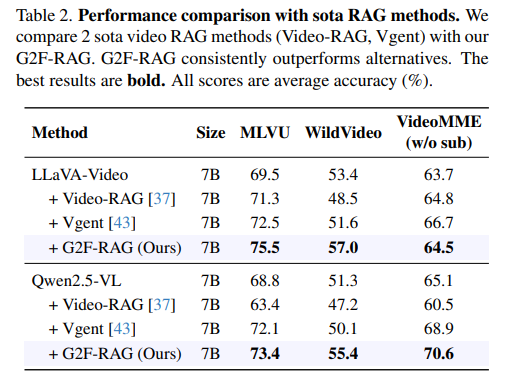
- 기존 Video-RAG 및 Vgent와의 비교에서도 G2F-RAG는 대부분의 설정에서 가장 높은 성능을 보입니다. 특히 Qwen2.5-VL-7B에서는 MLVU, WildVideo, VideoMME 세 벤치마크 모두에서 Vgent를 앞섭니다.
- 이러한 결과로부터 어떤 정보를 찾아왔는가뿐 아니라, 검색된 정보를 최종 모델에 어떤 표현과 지식 fusion 방식으로 전달할 것인가 역시 중요한 설계 축으로 작용할 수 있음을 보여줍니다.
- 다만 이러한 우위가 모든 조합에서 성립하는 것은 아닙니다. LLaVA-Video-7B의 VideoMME에서는 Vgent가 66.7점으로 G2F-RAG의 64.5점보다 높은 성능을 보이므로, G2F-RAG가 모든 백본과 벤치마크에서 전반으로 강한 경향을 보이나 일부 예외도 존재하고 있음을 알 수 있습니다.
Ablation ㅡ 무엇이 실제로 성능을 만들어내나?
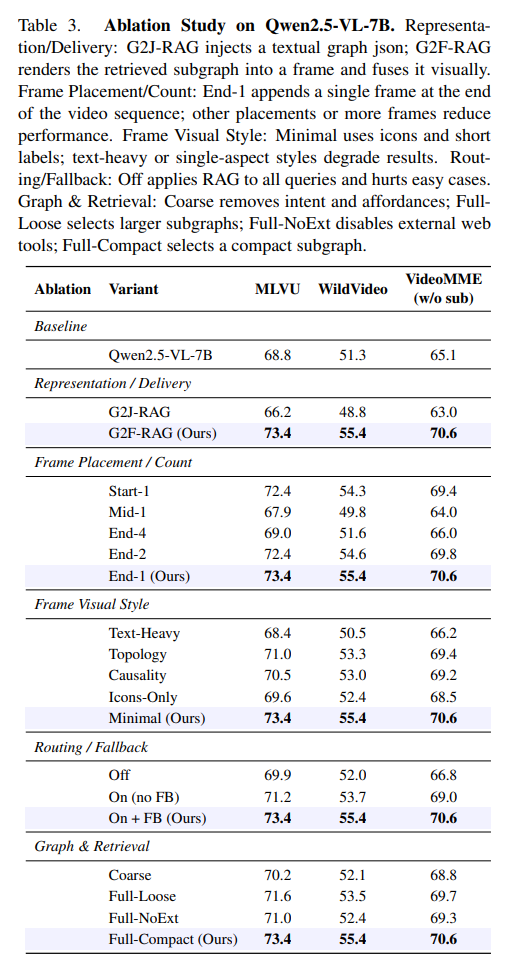
- 먼저 같은 서브그래프를 어떤 형태로 전달하는가만 바꿔도 큰 차이가 나타납니다. 동일한 서브그래프를 텍스트 JSON으로 주입하는 G2J-RAG와 비교했을 때, 시각 프레임으로 렌더링하는 G2F-RAG는 VideoMME에서 7.6점 더 높은 성능을 보입니다. 즉, 같은 정보를 텍스트로 전달할 것인지, 한 장의 시각적 표현으로 전달할 것인지라는 선택만으로도 상당한 성능 차이가 나타납니다.
- 프레임의 위치와 표현 방식 역시 중요했습니다. 배치 실험에서는 영상 끝에 한 장만 추가하는 End-1 설정이 가장 높은 성능을 보였고, 영상 중간에 프레임을 삽입한 Mid-1에서는 성능이 크게 낮아졌습니다.
- 저자들은 이를 원본 영상의 시간적 흐름을 방해하지 않으면서 마지막 reasoning frame을 참조할 수 있도록 하는 배치의 중요성으로 해석합니다.
- 시각화 스타일에서도 아이콘과 짧은 라벨을 중심으로 구성한 Minimal 방식이 가장 좋은 결과를 보였으며, 텍스트 비중이 커질수록 성능이 다시 낮아지는 경향이 나타났습니다.
- 마지막으로 언제 그래프 증강을 사용할 것인가도 성능에 영향을 줍니다. 라우팅과 fallback을 모두 적용한 조합이 세 데이터셋에서 가장 높은 성능을 보였고, 모든 질의에 그래프 프레임을 일괄적으로 적용하는 Routing Off 설정에서는 그보다 낮은 결과가 나타났습니다.
- 즉, G2F-RAG는 그래프 프레임 자체뿐 아니라 필요한 질문에 선택적으로 증강을 적용하는 전략까지 함께 사용할 때 가장 효과적이었습니다.
💡
검색된 서브그래프 자체가 같더라도, 이를 어떤 형태로 표현하고 어디에 배치하며 언제 사용할 것인지에 따라 결과가 크게 달라집니다.
이 Ablation 실험은 검색된 지식을 최소한의 시각 정보로 압축하고, 적절한 위치와 상황에서 전달하는 G2F-RAG 설계의 디테일을 보여줍니다.
이 Ablation 실험은 검색된 지식을 최소한의 시각 정보로 압축하고, 적절한 위치와 상황에서 전달하는 G2F-RAG 설계의 디테일을 보여줍니다.
- G2F-RAG는 오프라인 그래프 구축에는 GPT-4o, 온라인 라우팅과 검색에는 GPT-4o-mini 기반 에이전트를 활용합니다. 따라서 추가적인 백본 학습은 필요하지 않지만, 전체 파이프라인의 비용과 지연 시간까지 고려했을 때의 효율성은 현재 벤치마크 결과만으로 충분히 판단하기 어렵습니다.
- 또한 기본 렌더링은 Graphviz를 이용해 아이콘과 짧은 라벨 중심의 단일 프레임으로 구성되기 때문에, 인과관계가 훨씬 복잡하거나 등장 개체가 많은 영상에서도 질문에 필요한 정보를 한 장의 프레임 안에 얼마나 안정적으로 압축할 수 있는지는 앞으로 더 살펴볼 부분입니다.
💡
같은 지식이라도 어떤 표현으로, 어느 모달리티를 통해, 얼마나 압축해서 전달하느냐가 별도의 설계 문제가 될 수 있습니다.
- 최근 DeepSeek-OCR 등에서 제기되었던 시각 모달리티를 정보 압축의 매체로 활용할 수 있다는 관점을 그래프 구조로 확장했다는 점이 흥미로웠습니다. 그럼에도 G2F-RAG의 차별점이라고 느껴지는 부분은 그래프를 구축하고 검색하는 데서 끝나는 것이 아니라, 검색된 지식을 최종 모델이 활용하기 쉬운 형태로 어떻게 표현하고 전달할 것인가를 하나의 독립적인 설계 문제로 이끌어간 부분에 있습니다.
- 물론 관련 서브그래프를 선택하고 불필요한 관계를 제거하는 과정 자체는 기존 GraphRAG가 다뤄온 그래프 구조화와 retrieval의 문제와 이어져 있습니다만, 그래프에 구조화된 지식을 백본이 자연스럽게 처리할 수 있는 입력 형태로 변환하는 마지막 단계까지 RAG 파이프라인의 설계 대상으로 확장했다는 점을 위 논문의 핵심 인사이트로 꼽아볼 수 있을 듯 합니다.
Reference
- VisRAG – Text to Image embedding 상태로 검색 및 활용하는 설계 관점
- ColPali – Text to Text interface를 고집할 필요가 없다는 유사 철학의 관점
- 'Seeing beyond words, google I/O' – 멀티모달 RAG :
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184