26년 11월 4주차 그래프 오마카세
ATLASKV: AUGMENTING LLMS WITH BILLION-SCALE KNOWLEDGE GRAPHS IN 20GB VRAM
AtlasKV: Augmenting LLMs with Billion-Scale Knowledge Graphs in 20GB VRAM
Retrieval-augmented generation (RAG) has shown some success in augmenting large language models (LLMs) with external knowledge. However, as a non-parametric knowledge integration paradigm for LLMs, RAG methods heavily rely on external retrieval modules and the retrieved textual context prior. Especially for very large scale knowledge augmentation, they would introduce substantial inference latency due to expensive searches and much longer relevant context. In this paper, we propose a parametric knowledge integration method, called \textbf{AtlasKV}, a scalable, effective, and general way to augment LLMs with billion-scale knowledge graphs (KGs) (e.g. 1B triples) using very little GPU memory cost (e.g. less than 20GB VRAM). In AtlasKV, we introduce KG2KV and HiKVP to integrate KG triples into LLMs at scale with sub-linear time and memory complexity. It maintains strong knowledge grounding and generalization performance using the LLMs' inherent attention mechanism, and requires no external retrievers, long context priors, or retraining when adapting to new knowledge.
 Haoyu Huang
GitHub - HKUST-KnowComp/AtlasKV: [ICLR'26] A scalable, effective, and general way to augment LLMs with billion-scale knowledge graphs using very little GPU memory cost.
[ICLR'26] A scalable, effective, and general way to augment LLMs with billion-scale knowledge graphs using very little GPU memory cost. - HKUST-KnowComp/AtlasKV
Keywords
- Knowledge Graph to Key–Value(KG2KV)
- Hierarchical Key–Value Pruning (HiKVP)
- GPU Memory Efficiency
- 실무에서 수십억 건 규모의 엔터프라이즈 지식그래프를 LLM과 연결해 보신 분들이라면, 표준 GraphRAG 파이프라인이 가진 구조적 딜레마에 한 번쯤 부딪혀 보셨을 것입니다.
- 표준 아키텍처는 프롬프트로부터 엔티티 추출 - DB 또는 벡터 인덱스에서 서브그래프 탐색 - 텍스트 직렬화를 통해 LLM의 컨텍스트에 집어 넣는 Non-parametric 방식의 구조를 채택하고 있습니다. 다음 방식은 그래프 토폴로지 구조를 명시적으로 활용할 수 있다는 강력한 장점이 있으나, 그에 비례해 지식 그래프 크기까지 증가하여 병목이 함께 커진다는 한계가 있습니다.
- 병목이 커지게 되면 잘 아시다시피 레이턴시 증가, 토큰 길이가 길어짐에 따라 KV 캐시 메모리 점유율과 어텐션 연산량이 기하급수적으로 증가, 긴 문맥의 중간 정보를 놓치는 현상 (Lost in the middle 문제)이 발생합니다. 그렇다고 전통적인 파라메트릭한 방식 (LoRa, Adapter 등)을 사용하자니 기업 데이터 누출 및 업데이트마다 모델을 재학습시켜야하는 운영 부담이 발생합니다.
- 이번 주 오마카세에서 소개할 ICLR 2026 논문 AtlasKV는 이 지점에서 아키텍처의 판을 바꾸는 질문을 던집니다.
💡
지식그래프의 트리플 관계정보를 LLM 내부 Self-Attention의 Key–Value로 직접 연결하면 어떨까?
- 상당히 흥미로운 질문에서 비롯된 저자들의 핵심 주장을 요약하자면 검색기를 붙이거나 긴 컨텍스트 입력 없이, 그리고 새로운 지식이 추가되더라도 재학습 필요없이도 1B 규모의 지식 그래프 트리플을 20GB 미만의 GPU VRAM 만으로 LLM에 통합할 수 있다는 것입니다.
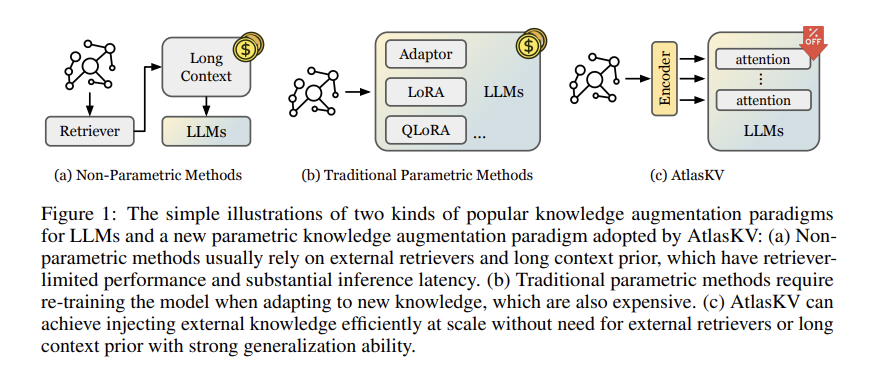
- Figure 1이 보여주듯, AtlasKV는 기존 두 패러다임의 절충점을 파고듭니다. 지식그래프의 트리플을 별도의 Key–Value 벡터로 인코딩한 뒤, LLM의 어텐션 레이어에 직접 주입하여 질문에 필요한 지식을 어텐션 점수 계산 과정에서 스스로 선택하게 만듭니다. LLM이 외부 Key–Value를 읽는 Projection 레이어만 초기 한 번 학습해 두면, 이후 새로운 도메인의 KG를 갈아 끼울 때는 모델 재학습 없이 Training-free하게 바로 확장할 수 있습니다.
- 어떻게 수십억개의 트리플을 어텐션이 이해하는 형태로 바꾸고, 제한된 GPU 메모리 안에서 필요한 정보를 추려낼 수 있을까? 질문에 논문 저자들은 2가지 축으로 답을 찾고자 하였습니다.
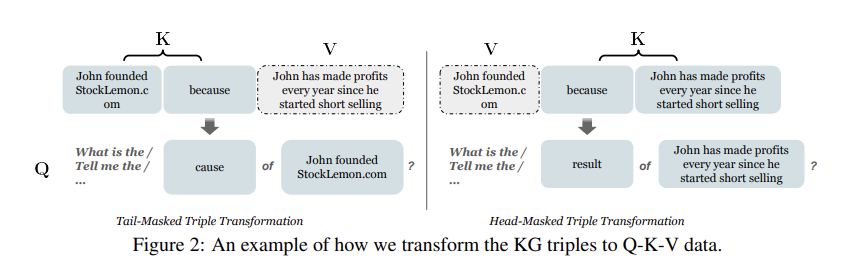
- 첫 번째 핵심 아이디어는 데이터 파이프라인인 KG2KV(Knowledge Graph to Key–Value)입니다. 저자들은 트리플 구조가 트랜스포머 어텐션의 Query-Key-Value 메커니즘과 본질적으로 닮아있다는 점에 주목했습니다. 즉, 트리플에서 한쪽 엔티티를 마스킹하면, 나머지 엔티티와 관계는 무엇에 관한 정보인지를 나타내는 Key가 되고, 가려진 엔티티는 그에 대한 정답인 Value가 됩니다.
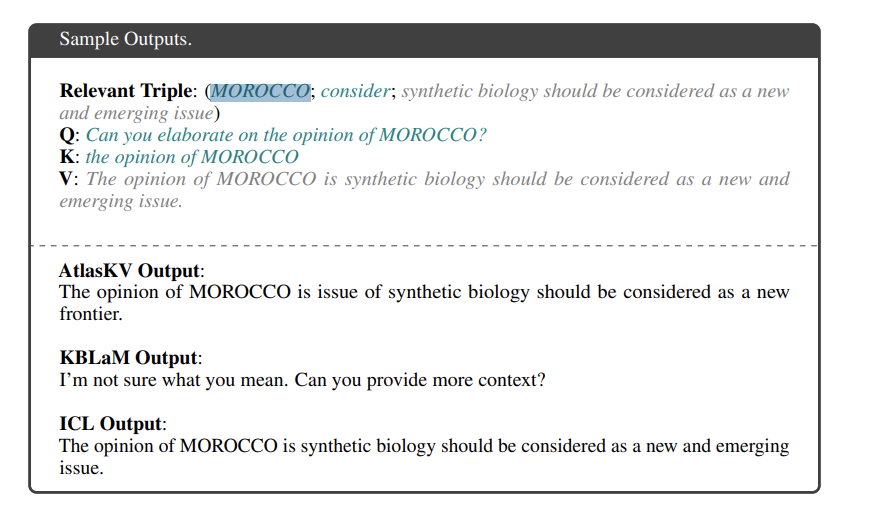
- 눈여겨볼 디테일은 Relation Rewriting입니다. 단순히 엔티티와 관계 문자열을 기계적으로 이어 붙이지 않고, 경량 LLM을 활용해 어느 쪽 엔티티를 가렸는지에 따라 관계를 자연스러운 명사형 속성으로 바꿉니다. 이후 변환된 Key와 Value 문장을 Sentence Encoder로 임베딩해 Attention 레이어에 공급합니다.
- 기존에도 외부 지식을 Key–Value로 변환해 Attention에 넣으려던 시도로 KBLaM이 있었습니다. 하지만 KBLaM은 일반 문서에서 사전 정의된 소수의 고정 스키마로 합성 데이터를 만들어 학습했기 때문에, 실제 Out of Distribution(OOD)에 매우 취약했습니다.
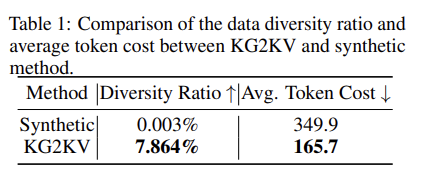
- 반면 KG2KV는 지식그래프 본연의 풍부한 관계를 그대로 활용합니다. 그렇기에 더 다양한 의미적 관계를 모델에 노출할 수 있어 전체 트리플 대비 고유한 쿼리 속성 비율은 압도적으로 높아지면서, 관계 구문만 변환하면 되므로 데이터 생성에 드는 토큰 비용은 절반 이하로 줄었습니다 (Table 1 참고).
- 결국 KG2KV는 그래프에 기록된 다양한 관계를 이용해 LLM이 외부 지식을 찾아 활용하는 방법 자체를 학습시키는 것에 가깝다고 볼 수 있겠습니다.
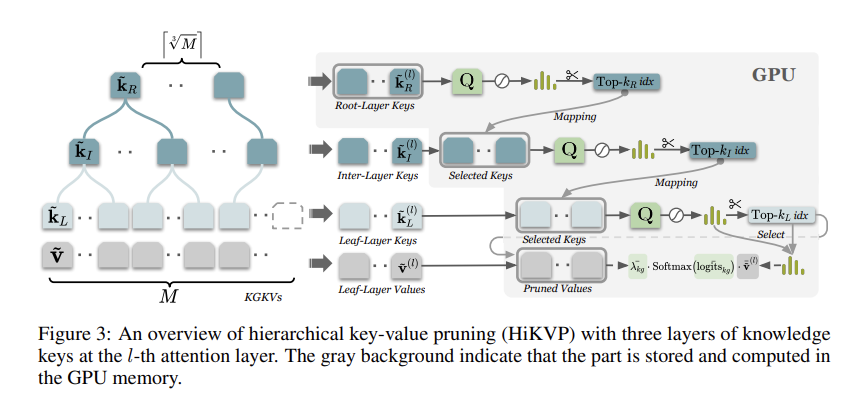
- 두번째 핵심 알고리즘은 HiKVP(Hierarchical Key–Value Pruning) 을 도입합니다. 이는 수십억개의 트리플 개수를 매 토큰 생성시마다 내적하고 GPU 메모리에 올려두는 것의 불가능함을 해소하기 위한 시스템 엔지니어링 관점의 아이디어입니다. 전체적으로 한번에 확인하는 것 대신 계층적으로 정리된 지식 중에서 질문과 관련성이 높은 영역을 먼저 선택하고, 그 안에서 필요한 지식으로 범위를 좁혀가는 방식입니다.
- 오프라인 계층 군집화 : 전체 key 임베딩을UMAP을 통해 차원 축소한 후, Gaussian Mixture Models (GMMs)으로 군집화하여 [Root - Intermediate - Leaf]의 3단계 계층 트리를 구성합니다.
- 온디맨드 GPU 로딩 : 추론이 시작되면 최상위 Root Layer의 대표 Key만 GPU VRAM에 올립니다. 나머지 대부분의 Key와 실제 Value 데이터는 상대적으로 RAM에 대기합니다.
- 단계별 가지치기 : 쿼리와 점수가 높은 상위 k개의 Root 노드를 고른 뒤, 그에 속한 Intermediate Key만 CPU에서 GPU로 가져옵니다. 같은 방식으로 Leaf Layer까지 좁혀 들어가며 최종 지식을 추려내 어텐션 연산에 반영합니다.
- 위 Figure 3은 이 과정을 보여줍니다. 특히 회색으로 표시된 GPU 영역을 살펴보면 전체 지식을 GPU에 상주시킬 필요가 없다는 것을 확인할 수 있습니다. 대부분의 Key와 Value는 CPU 메모리에 유지하고, 각 단계에서 필요한 일부만 GPU로 이동합니다.
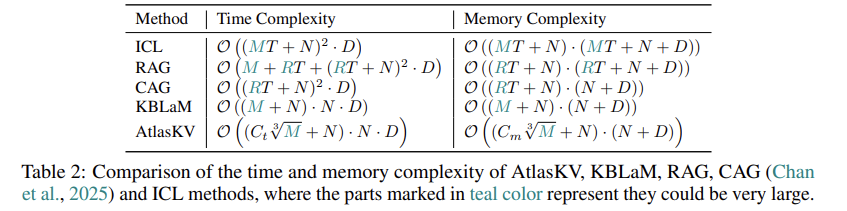
- 이 계층적 구조 덕분에 지식 접근의 이론적 시간 및 메모리 복잡도는 전체 트리플 수에 선형으로 비례하던 기존 KBLaM과 달리 Sub-linear 수준으로 떨어진다고 분석합니다. 다만 계층적 군집을 사전에 구축하고, 지식 임베딩을 저장하며, CPU와 GPU 사이에서 데이터를 전달하는 비용은 별도로 존재합니다. HiKVP의 Sub-linear 복잡도는 논문이 분석한 계층적 어텐션 접근 과정에 대한 결과입니다.
- 또 하나 눈여겨볼 점은 기존 RAG에서는 Retriever가 수행하던 관련 정보 선택을 LLM의 Attention과 계층적 Pruning이 담당하게 설계되었다는 점입니다. 즉, AtlasKV는 검색을 없앴다기보다 검색의 위치와 방식을 바꾼 방법으로 이해할 수 있겠습니다.
- 연구진은 LLaMA 3.1 8B Instruct를 기반 모델로 사용하고, 외부 지식과의 연결을 위한 Attention 관련 파라미터를 학습했습니다. 학습 데이터는 ATLAS-Wiki Knowledge Graph에서 추출한 20,000개의 트리플을 사용했으며, 기본 실험에서는 3,000회의 학습 단계를 수행했습니다.
- 평가에서는 Enron뿐 아니라 ATLAS-CC-QKV와 ATLAS-Pes2o-QKV 데이터셋을 활용했습니다. 학습에 사용하지 않은 지식과 관계 속성에 대해서도 제대로 작동하는지 확인하기 위한 OOD 평가입니다.
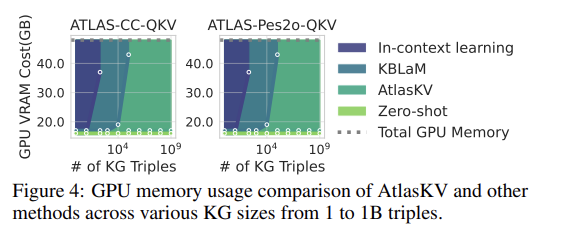
- 논문 제목에서도 강조하고 있듯이 메모리 효율 측면을 살펴보겠습니다. Figure 4에서는 지식그래프의 트리플 수를 1개부터 10억 개까지 증가시키면서 GPU 메모리 사용량을 비교합니다. 저자들은 KBLaM이 10만 개의 트리플에서도 40GB 이상의 VRAM을 요구하는 반면, AtlasKV는 10억 개의 트리플을 사용하는 설정에서도 20GB 미만의 GPU 메모리를 사용한다고 보고합니다.
- 이는 GPU에 모든 Key와 Value를 올려놓는 대신, CPU 메모리에서 필요한 부분만 순차적으로 불러오기 때문에 대규모 지식그래프를 상대적으로 작은 GPU 메모리 예산 안에서 활용할 수 있는 것입니다.
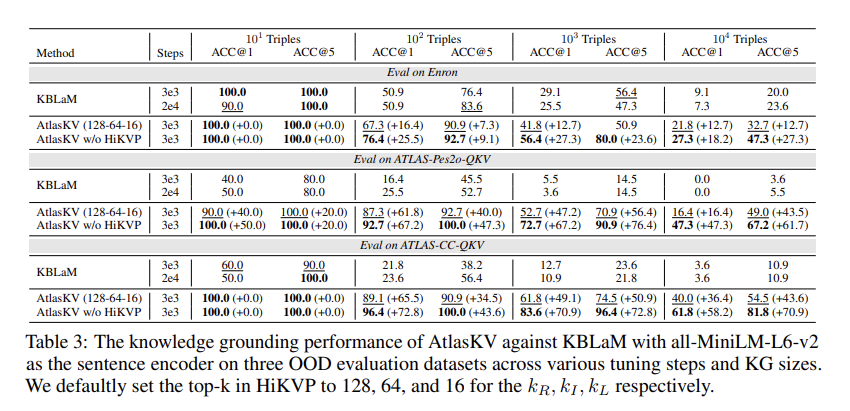
- 메모리 효율 뿐만 아니라, 실제 질문에 필요한 지식을 제대로 찾아낼 수 있는지도 활용 가치 측면에서 매우 중요합니다. 저자들은 이를 확인하기 위해 Attention이 정답에 해당하는 지식을 얼마나 정확하게 선택하는지 ACC@1과 ACC@5로 측정합니다.
- KG2KV의 다양한 관계 학습 덕분에, 세 데이터셋 모두에서 AtlasKV가 KBLaM보다 높은 정확도를 보입니다. 허나 여기서 주목할만한 부분은 HiKVP를 적용하지 않았을 때의 정확도 격차도 뚜렷하게 드러납니다 (ATLAS-CC-QKV에서는 61.8%에서 40.0%로, ATLAS-Pes2o-QKV에서는 47.3%에서 16.4%로 낮아집니다.) 계층적 군집 탐색 과정에서 상위 단계가 잘못 가지치기되면 하위 단계의 정답에 도달할 수 없기 때문이며, 이는 논문에서 중요한 Trade-off입니다.
- 즉, 얼마나 많은 지식에 접근할 수 있는가와 그 중에서 정답을 얼마나 정확하게 선택하는 것은 서로 다른 문제라는 것을 알 수 있습니다.
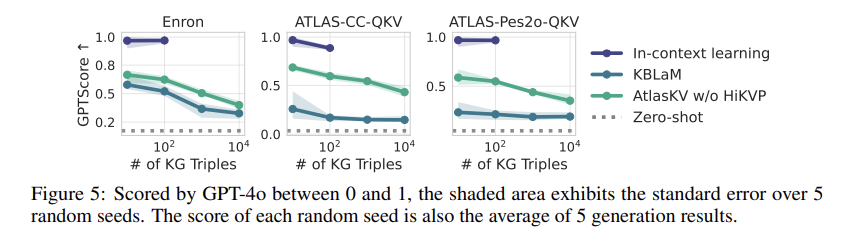
- 지식 선택 정확도 외에도 생성된 답변이 정답과 얼마나 관련되어 있는지 GPT-4o를 평가 모델로 사용해 측정했습니다. 그로부터 얻어낸 최종 GPTScore에서도 AtlasKV는 KBLaM보다 월등히 높은 점수를 기록했습니다.
- 모든 지식을 프롬프트에 직접 넣는 ICL(In-Context Learning)이 가장 높은 점수를 내긴 하지만, 많은 정보를 Context에 직접 넣어야 하므로 메모리 사용량이 빠르게 증가했습니다.
- 해당 논문의 Appendix을 참고해보면 아직 해결해야 할 문제들도 남아 있습니다.
그래프를 활용하지만, 그래프의 구조는 사라진다.
- AtlasKV는 KG2KV 과정에서 각각의 트리플을 독립적인 Key–Value 지식으로 변환합니다. 따라서 원래 그래프에서 명시적으로 존재하던 엔티티 간 연결 관계나 다단계 경로가 어텐션에 그대로 보존되는 것은 아닙니다. 모델이 각각의 사실에 접근할 수 있더라도 그 사이 경로가 구조적으로 보장되진 않는다는 의미입니다.
- Appendix J에서 이를 Loss of Graph Structure 한계로 인정하고 있습니다. 트리플 관계를 독립된 사실로 flattening하기 때문에 지식그래프를 활용한 Multi-hop reasoning의 제한이 존재합니다. 따라서 그래프의 온전한 연결 구조를 보존하는 것이 아니라, 그 관계에서 추출한 사실을 어텐션 기반으로 활용한 방식에 가깝다고 볼 수 있습니다.
메모리 절약이 빠른 추론을 보장하는 것은 아니다.
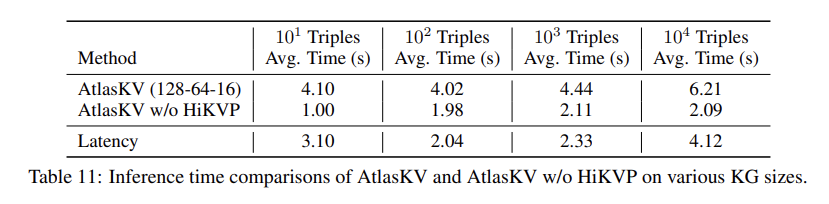
- 위 본문에서도 언급하였듯, HiKVP는 GPU 메모리를 절약하기 위해 필요한 Key와 Value를 CPU에서 GPU로 가져올 때 이러한 계층별 데이터 전송에도 시간이 소요됩니다. Table 11에서의 설정에서는 HiKVP를 적용한 쪽이 약 3배 더 느렸음을 보고합니다.
- 이는 Pruning을 사용하지 않는 방식은 지식 규모가 훨씬 커질 때 GPU 메모리 부담이 커지기 때문입니다. 다만 메모리 확장성을 얻는 대가로 CPU-GPU 데이터 이동에 따른 지연시간을 부담할 수 있다는 점은 실무적으로 중요한 포인트입니다.
새로운 지식 추가는 무료가 아니다.
- 마지막으로 KG2KV의 변환 비용입니다. 새로운 그래프를 연결할 때 LLM의 파라미터를 다시 학습할 필요는 없지만, 그래프의 관계를 Key–Value로 변환하고 임베딩을 생성하는 과정은 여전히 필요합니다.
- 특히 Relation Rewriting은 그래프가 커질수록 상당한 토큰 비용을 발생시킬 수 있습니다. 연구진도 이를 고려해 Relation Rewriting을 생략하는 실험을 수행했으며, 일부 정확도 저하를 감수하면 변환 비용을 줄일 수 있다는 결과를 보고합니다.
💡
외부 지식을 LLM에 전달할 때 질문에 필요한 사실을 충분히 정확하게 선택할 수 있다면 그것만으로도 괜찮을까?
- 최근 GraphRAG 연구들이 어떤 지식을 검색할 것인가와 그 지식을 어떤 형태로 전달할 것인가를 고민했다면, AtlasKV는 한 단계 더 나아가 외부 지식이 LLM의 어느 계산 단계에서 사용되어야 하는가라는 핵심 질문에서 진행된 연구로 바라볼 수 있을 것 같습니다.
- AtlasKV는 지식그래프에서 얻은 사실을 Key–Value로 인코딩하고, LLM의 어텐션이 필요한 정보를 직접 선택하도록 합니다. 이를 가능하게 만든 KG2KV는 다양한 그래프 관계를 학습 데이터로 활용해 지식 접근의 일반화 성능을 개선했고, HiKVP는 대규모 지식에 접근할 때 GPU 메모리 사용량을 억제하는 역할을 했습니다. 하지만 각 트리플을 독립적인 사실로 표현하기 때문에, 그래프의 경로와 위상적 관계를 그대로 활용하는 데는 한계가 있었습니다.
- AtlasKV을 요약하면 외부 지식을 LLM이 접근하는 방식을 바꾸었다는 점에 있습니다. 다음의 두 핵심 알고리즘은 외부 지식을 활용한다는 목표는 공유하지만, 무엇을 보존하고 무엇을 효율화할 것인지에 대한 역할 분담이 달랐습니다.
- KG2KV는 어떤 지식을 어떻게 표현하고 학습할 것인가, 즉 지식 선택에서의 품질을 고려하였고
- HiKVP는 그 지식이 매우 많아졌을 때 얼마나 효율적으로 접근하여 GPU 메모리에 올릴 것인가, 즉 확장성과 정확도 균형에 직접적인 연관이 있습니다.
- GraphRAG에서는 그래프의 연결 구조를 명시적으로 탐색할 수 있다는 장점이 있습니다. 경로에 따른 추론이나 관계 추적이 중요한 문제에서는 이러한 구조 자체가 중요한 정보가 됩니다. 하지만 이번 논문을 읽어보시면 앞으로는 GraphRAG + Attention 기반의 지식 접근 결합방식 또는 계층적인 Key-value 표현 상 그래프의 구조 관계까지 보존하는 자연스러운 방향이 잡힐 수 있으며 상당히 흥미로운 주제가 될 것으로 생각됩니다.
- 그래프를 Key–Value 형태로 압축하는 과정에서 연결 구조를 잃을 수 있다는 인사이트로부터, 결국 중요한 것은 그 지식을 어떤 구조로 보존하고 모델이 어떻게 활용하도록 만들 것인지 설계하는 방식에 달려있겠습니다.
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184