26년 11월 2주차 그래프 오마카세
#GUG X AWS NEPTUNE WORKSHOP 안내
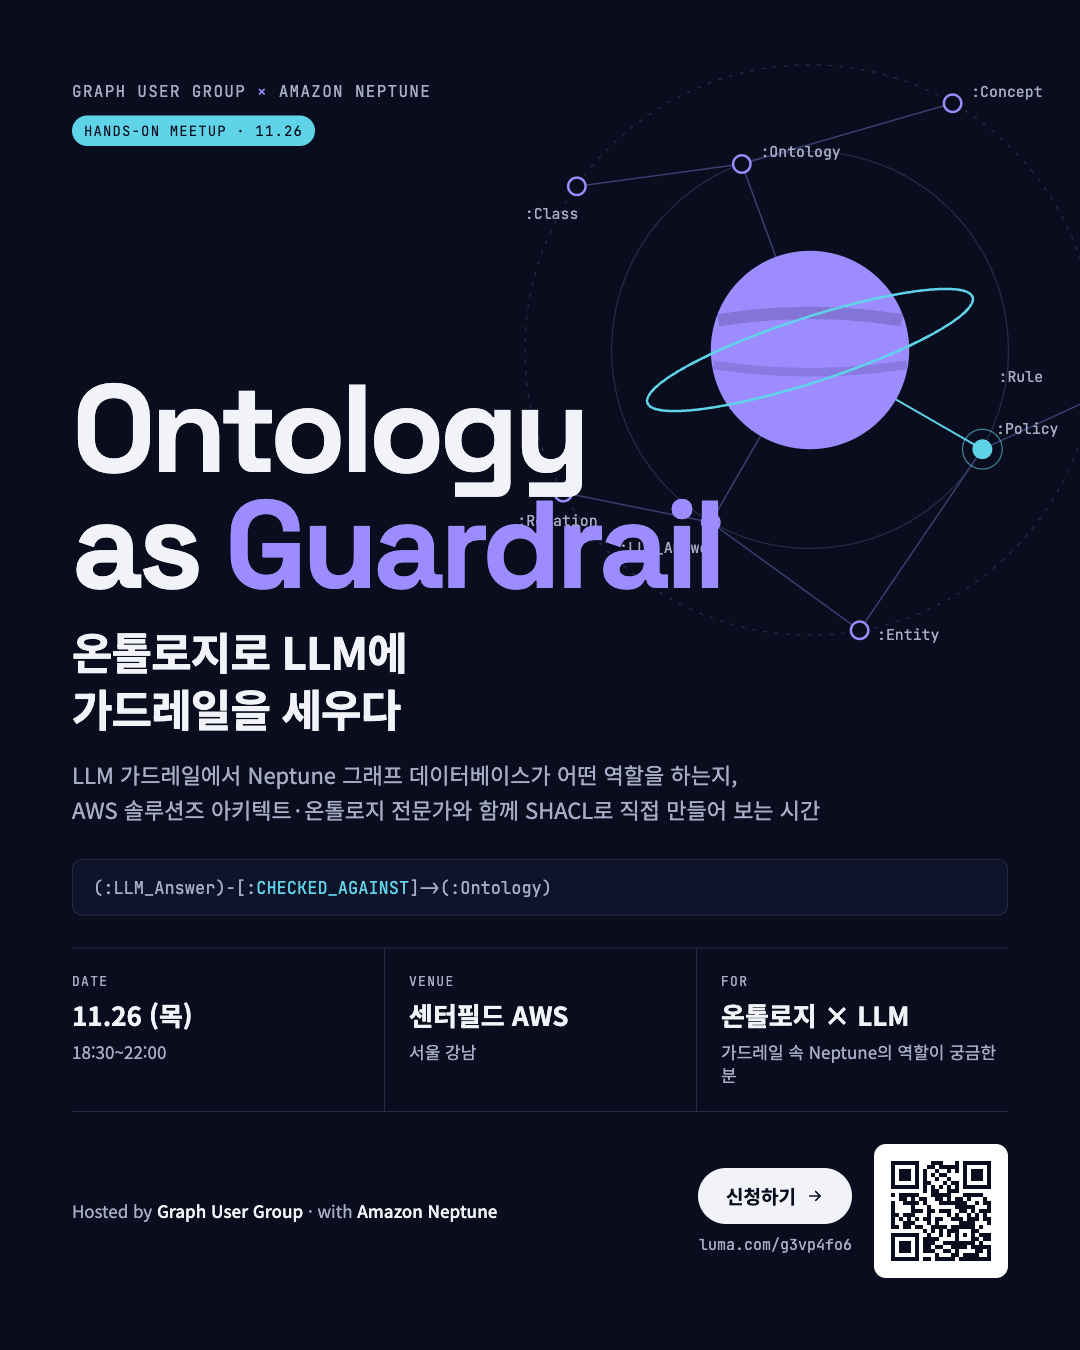
11월 26일(목), AWS Neptune 팀과 함께 Enterprise Ontology를 Agentic AI에 적용하는 워크숍을 진행합니다.
그동안 많은 기업과 엔지니어들이 Enterprise Ontology를 구축하기 위해 노력해 왔습니다. 하지만 잘 구축된 Ontology를 LLM이 실제로 이해하고, 활용하고, 나아가 기업의 의사결정에 반영하도록 만드는 것은 또 다른 문제라 생각하는데요.
이번 워크숍에서는 이 고민을 함께 풀어보고자 합니다. AWS에서는 장동훈 솔루션 아키텍트님, GUG에서는 온톨로지 전문가이신 Chaeeun Song님이 함께합니다.
Graph DB인 Amazon Neptune을 깊이 이해하는 전문가와 Ontology 전문가가 만나면 어떤 시너지가 만들어질까요? 두 영역의 전문성을 연결하여, 여러분이 구축한 Enterprise Ontology를 Agentic AI에 효과적으로 활용하는 방법을 함께 살펴볼 예정입니다.
이번 워크숍에서 다루는 내용은 KGC 2026에서 AWS Neptune 팀이 진행한 "Why Agentic AI at Scale Demands Formal Ontology" 워크숍 세션을 기반으로, 주요 내용을 다시 경험할 수 있도록 준비하고 있습니다.
이걸 기획한 이유는 AI가 처리하는 의사결정의 규모는 빠르게 커지고 있는데요. 예를 들어 하루 50건의 의사결정을 사람이 직접 수행하던 환경에서, AI Copilot을 통해 5,000건을 지원하고, Autonomous Agent가 50,000건을 처리하는 환경으로 확장된다면 어떨까요?
이러한 규모에서는 모든 의사결정을 사람이 일일이 검토하는 방식만으로는 대응하기 어렵습니다. 그렇다고 AI Agent가 기업의 맥락과 규칙을 이해하지 못한 채 자율적으로 판단하도록 두기에는 불안하구요. 바로 여기서 Enterprise Ontology의 역할이 중요해지는데요.
기업이 정의한 개념, 관계, 비즈니스 규칙과 시맨틱을 AI Agent가 이해하고, 이를 근거로 일관성 있는 의사결정을 수행하도록 만드는 것입니다. 이번 워크숍은 이러한 문제의식에서 출발합니다. 단순히 Ontology를 구축하는 데 그치지 않고, 실제 Agentic AI 시스템에서 Neptune 과 온톨로지 조합을 통해 어떻게 활용할 수 있을지 살펴보는 시간이 되었으면 합니다.
이번에는 이전 GUG 행사와 달리 비교적 작은 공간에서 진행되는데요. 공간적인 제약도 있지만, 무엇보다 워크숍의 밀도를 높이고 참석자 간의 깊이 있는 기술적 교류가 이루어질 수 있도록 참석 인원을 약 25명으로 제한하려고 합니다.
따라서 현재 Enterprise Ontology를 구축하고 계시거나, Knowledge Graph와 Agentic AI의 접점을 고민하고 계신 분들, 실제 업무에 적용하려는 구체적인 문제의식이 있으신 분들께 특히 추천드립니다. 소수의 인원이 모이는 만큼, 각자가 가진 고민과 경험을 나누고 실질적인 인사이트를 얻어 가는 자리가 되었으면 좋겠습니다.
11월 26일, 워크숍에서 뵙겠습니다!
채은님의 온톨로지 보물창고; https://shinysong.github.io/shacl-graphrag/journal/2026-11-05-review-xpshacl/
행사 신청링크 ; https://luma.com/g3vp4fo6
Graph-Mediated Large Language Model Systems in the Agentic Era: Reasoning, Knowledge, Retrieval, Execution, and Coordination
 Haihui Liu
- 최근 LLM과 그래프를 결합하는 연구는 상당히 다양한 방향으로 발전하고 있습니다. 대표적인 예시로, GraphRAG에서는 지식 간 연결을 활용해 검색을 개선하고, Graph Memory에서는 에이전트의 이전 작업들의 메모리 및 핵심 정보를 기억하도록 합니다. 또한 Agent Workflow에서는 작업 간 의존성을 관리하고, Multi-Agent System에서는 여러 에이전트의 통신 구조를 그래프로 표현하기도 합니다.
- 흥미로운 점은 모두 그래프를 사용하지만, 그래프가 실제로 수행하는 역할은 서로 다르다는 것입니다. 어떤 시스템에서는 그래프가 추론의 대상이고, 다른 시스템에서는 필요한 지식을 찾는 검색 구조이며, 또 다른 시스템에서는 에이전트의 실행 순서를 통제하는 역할을 맡습니다.
- 이렇게 여러 분야에서 널리 사용되고 있는 그래프 기반 AI, 특히 LLM 패러다임의 빠르게 발전하고 있는 최신 시스템들을 하나의 관점으로 통합해서 바라볼 수는 없을까요? 또한 단순히 그래프를 도입했다는 이유만으로 성능 개선까지 이어지는 것은 아니었으니, 그 성공적인 응용 사례들을 깔끔하게 정리해볼 필요가 있을 것 같습니다.
- 이번 주 오마카세로 전달해드릴 논문은 공개된 연구들을 중심으로 핵심 메터니즘과 실험적 근거를 비교하는 정성적 서베이 논문으로써, 응용 분야별 그래프 활용 사례들을 나열하는 데 그치지 않고, 그래프가 어떤 기능을 수행하는지와 그 기능을 누가 계산하고 실행하는가를 구분하여 설명합니다. 나아가 그래프를 활용한 개별 단계의 개선이 이후의 의사결정과 전체 시스템 성능에 어떻게 연결되는지도 검토합니다.
- 이번 논문은 그래프가 오늘날 AI 시스템에서 왜 중요한 역할을 맡게 되었는지, 어떤 문제를 해결하기 위해 활용되며 실제로 어떤 이점을 제공하는지를 종합적으로 살펴볼 수 있는 서베이입니다. 지금까지 그래프 오마카세를 통해 함께 살펴본 여러 연구와 인사이트를 되짚어보고, 그래프의 역할과 가치를 조금 더 체계적으로 정리해보는 기회가 될 것 같습니다.
그래프는 AI 시스템에서 어떤 역할을 수행할까?
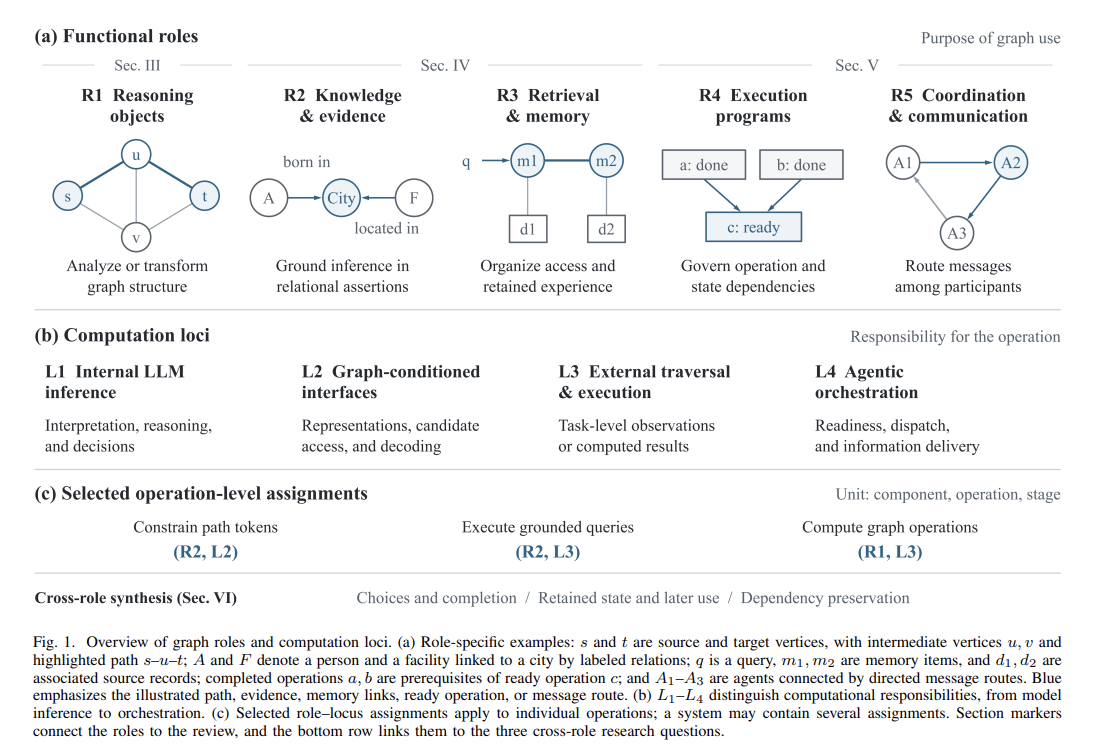
- 저자들은 시스템 내부에서 개별 그래프 연산이 수행하는 목적을 기준으로 그래프의 기능을 다섯 가지 역할(R1–R5)로 구분합니다.
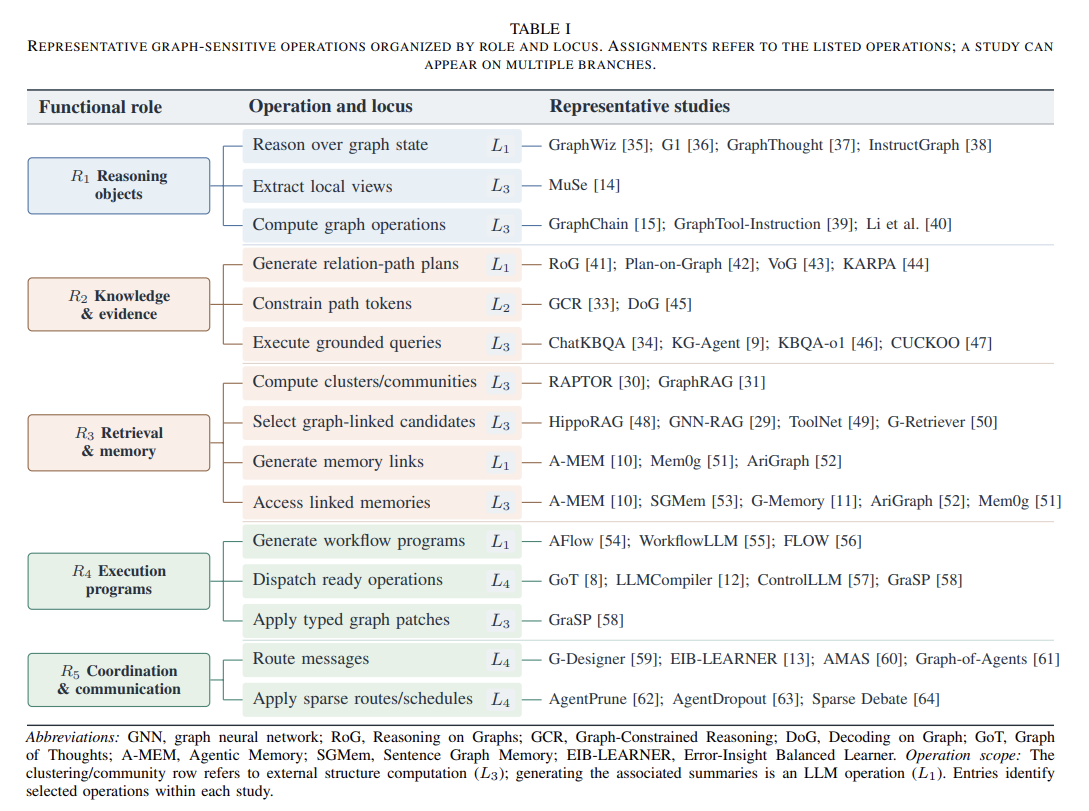
- R1 (Reasoning Objects) : 그래프 자체를 분석하고 문제를 해결하는 데 집중, 대표적으로 GraphWiz(KDD 2024), GraphChain(NeurIPS 2025)
- R2 (Knowledge & Evidence) : 지식 관계를 해석하고 추론의 근거를 제공, 대표적으로 RoG(ICLR 2024), ChatKBQA(ACL Findings 2024)
- R3 (Retrieval & Memory) : 정보 검색과 경험의 저장 및 접근을 조직, 대표적으로 GraphRAG, HippoRAG(NeurIPS 2024), A-MEM(NeurIPS 2025)
- R4 (Execution Programs) : 작업 간 의존성과 실행 순서를 관리, 대표적으로 LLMCompiler(ICML 2024) , GraSP
- R5 (Coordinate & Communication) : 에이전트 간 메세지 전달과 협업 관계를 관리, 대표적으로 G-Designer(ICML 2025), AgentPrune(ICLR 2025)
- R1은 그래프 자체가 문제의 대상인 경우입니다. 최단 경로를 찾거나 그래프의 구조를 분석하는 작업이 여기에 해당합니다. LLM이 그래프 알고리즘을 직접 수행하도록 학습할 수도 있고, GraphChain처럼 외부 그래프 연산 도구를 선택해 결과를 활용하도록 구성할 수도 있습니다.
- R2에서는 그래프가 추론을 뒷받침하는 지식과 증거의 역할을 수행합니다. 예를 들어 지식그래프에 저장된 개체와 관계를 따라 질문에 필요한 근거를 찾거나, ChatKBQA처럼 질문을 실행 가능한 논리식으로 변환해 데이터베이스에서 답을 계산하는 방식입니다.
- R3는 저희들에게 꽤나 익숙한 분야입니다. GraphRAG와 HippoRAG는 그래프의 관계를 활용해 관련 정보를 검색하며, A-MEM이나 Mem0g 같은 연구는 에이전트가 이전 상호작용에서 얻은 정보를 저장하고 다시 활용하는 문제를 다룹니다. 이때 그래프는 단순한 저장소가 아니라 어떤 정보를 연결하고, 무엇을 다시 불러올지 결정하는 구조가 됩니다.
- R4부터는 그래프의 역할이 정보 처리에서 시스템 실행으로 확장됩니다. 예를 들어 LLMCompiler는 작업 간 의존성을 바탕으로 선행 작업의 결과가 준비되면 후속 작업을 실행합니다. GraSP는 여기에 작업의 사전·사후 조건을 검사하고 실패 시 의존 구조를 수정하는 복구 메커니즘까지 포함합니다.
- R5은 여러 에이전트가 협업하는 환경을 다룹니다. 모든 에이전트가 서로에게 모든 정보를 보내는 대신, 그래프를 통해 누가 누구에게 정보를 전달할지 결정하는 것입니다. 에이전트 사이의 연결을 선택하거나 일부 연결을 제거해 통신 비용과 협업 성능의 균형을 조정하는 연구들이 여기에 해당합니다.
- 최근 오마카세에서는 R4, 5의 주제들에 집중해서 전달해드리고자 했었습니다. 여기에서 특히 구분할 부분은 R4의 실행 의존성과 R5의 통신 의존성입니다. R4는 어떤 작업이 완료되어야 다음 작업을 시작할 수 있는가를 다루고, R5는 어떤 에이전트에게 정보가 전달되어야 하는가를 다룹니다. 두 구조 모두 그래프로 표현할 수 있지만 해결하려는 문제는 다릅니다.
- 또한 하나의 시스템이 여러 역할을 동시에 수행할 수 있습니다. 예를 들어 에이전트가 지식그래프에서 정보를 검색하고(R3), 그 정보를 추론 근거로 사용한 뒤(R2), 다음 도구 호출의 실행 여부를 결정한다면(R4), 각 단계에서 그래프의 기능은 달라집니다.
- 따라서 저자들은 시스템 전체에 하나의 분류를 부여하기보다 개별 연산과 실행 단계별로 역할을 분석할 것을 제안합니다.
그래프를 활용하는 것과 그래프 연산을 직접 수행하는 것은 어떻게 다를까?
- 큰 틀에서 그래프의 역할을 구분했으니, 다음 질문은 실제로 그래프를 처리하는 주체는 누구인가? 이 되겠습니다. 이 구분이 중요한 이유는 LLM이 그래프 정보를 보고 스스로 계산하는 것과, 외부 시스템이 계산을 완료한 결과를 LLM에 전달하는 것은 서로 다른 접근이기 때문입니다.
- 저자들은 이를 네 가지 계산 계층(Computation Loci, L1–L4)으로 구분합니다.
- L1 (Internal LLM Inference) ; LLM이 그래프를 해석하고 추론 및 판단을 수행함.
- L2 (Graph-Conditioned Interfaces) : 그래프 구조로 모델 입력, 후보, 토큰 생성을 제약함.
- L3 (External Traversal & Execution) : 외부 도구가 그래프 탐색, 쿼리, 계산을 수행함.
- L4 (Agentic Orchestration) : 작업 준비 상태, 실행, 정보 전달을 관리함.
- 논문에서는 MuSe와 GraphChain을 예시로 동일한 외부 그래프 도구를 사용하지만, 최종 계산의 책임을 어디에 두는지가 다른 경우를 비교합니다. 직관적으로 MuSe는 문제를 해결하기 위해 필요한 지도를 보여주는 방식이고, 반면 GraphChain은 지도 위에서 필요한 경로 계산을 도구에 맡기는 방식입니다.
- Knowledge Graph QA에서도 비슷한 차이를 발견할 수 있습니다. Graph-Constrained Reasoning은 허용된 관계 경로를 벗어나지 않도록 생성 과정을 제한하고, ChatKBQA는 질문을 계산 가능한 형태로 해석해 결과를 얻는 방식입니다. 두 방법 모두 지식그래프를 사용하지만, 보장하는 속성은 서로 다르기 때문에 단순히 유효한 경로를 생성했다는 사실만으로 질문의 의미를 올바르게 이해했거나 정답을 얻었다고 보장할 수는 없습니다.
- 모델에 어떤 정보를 제공하고, 어떤 연산을 위임하며, 어떤 제약을 실행 단계에서 강제하는지가 시스템 동작을 이해하고 설명하는 데 더 직접적이기 때문에 특히 GraphRAG나 Agent Workflow를 설계할 때 유용한 구분이 될 수 있습니다.
그래프를 활용하면 정말 성능이 좋아질까?
- 개인적으로 이 부분이 이번 서베이의 중요한 메시지라고 생각합니다. 해당 논문에서는 무작정 그래프의 장점만을 나열하고 소개하지 않았습니다. 저자들은 여러 선행연구를 비교하며 개별 단계의 성능 향상이 반드시 최종 작업의 성능 향상으로 이어지지는 않는다는 점을 강조합니다.
- 첫 번째 사례는 GNN-RAG입니다. 이 연구의 특정 ComplexWebQuestions 실험에서는 후보 서브그래프를 희소화했을 때 GNN의 노드 예측 성능이 개선되었습니다. 그러나 그 결과를 이용해 LLM이 질문에 답변하는 단계에서는 오히려 성능이 떨어졌습니다. 일부 연결을 제거하면 노드 예측에는 도움이 되더라도, 답변에 필요한 경로까지 끊어질 수 있기 때문입니다.
- 즉, 검색된 정보의 양이나 개별 노드의 예측 정확도뿐 아니라, 질문에 등장하는 개체와 정답 후보를 연결하는 근거 경로가 남아 있는지가 중요합니다
- 두 번째는 Graph Memory와 Flat Memory의 비교입니다. Hu et al.(2026)의 연구에서는 검색을 위해 구성한 그래프 메모리와 평면적인 메모리의 상대적 성능이, 최종적으로 어떤 정보를 모델에 반환하는지에 따라 달라졌습니다. 원본 대화 내용을 반환하는 경우와 추출, 가공된 정보를 반환하는 경우에 그래프와 비그래프 방식의 우열이 뒤바뀐 것입니다.
- 검색 결과에 포함된 정보량과 표현 형태도 함께 달라졌기 때문에 그래프 구조 자체의 효과가 독립적으로 확인된 것은 아니며, 메모리를 그래프로 표현했다는 사실과 그 메모리가 실제로 더 좋은 답변을 제공하는가는 별도로 평가해야 합니다.
- 세 번째는 Multi-Agent Communication입니다. EIB-LEARNER에서 수행한 정보 전달 실험에서는 희소한 통신 구조가 잘못된 정보의 영향을 줄이는 동시에, 올바른 정보의 전달 효과도 줄이는 경향을 보였습니다. 반대로 연결이 많은 구조는 유용한 정보뿐 아니라 오류의 영향도 더 넓게 전달할 수 있었습니다. 이 결과는 연구에서 설정한 정보 주입 방식과 통신 구조별 평가 조건에 한정됩니다.
- 위의 사례들을 놓고 보면, 그래프의 일부 연결을 제거하거나 추가하는 결정이 그 다음 단계에 어떤 영향을 미치는지까지 고려해야 한다는 사실이 중요합니다. 개별 지표의 개선도 중요하지만 그 결과가 실제로 유용한지 확인하는 것은 별개라는 것을 알 수 있습니다.
에이전트 시대의 그래프는 무엇까지 관리해야 할까?
- 에이전트가 여러 단계에 걸쳐 외부 환경과 상호작용하면서 발생할 수 있는 새로운 문제에 대해, 메모리 속 사실을 올바르게 수정하는 것과 그 사실에 의존하는 계획, 도구 호출, 에이전트의 행동을 함께 수정하는 것은 별개의 문제입니다.
- 저자들은 이러한 문제를 세 가지 연구 질문(RQ1–3)으로 연결하면서, 어떤 관계가 이후 작업에 실제로 필요하고, 그 관계가 수정되었을 때 어디까지 다시 검증해야 하는지를 구체적으로 파악하자고 제안합니다.
- RQ1 (Decisions & Completion) : 에이전트는 정보가 부족한 경우, 질문을 잘못 해석한 경우, 도구 실행이 실패한 경우를 구분할 필요가 있습니다. 모두 추가 작업이 필요할 수 있지만 수행해야 할 행동은 다를 수 있으며, 언제 추가로 탐색하고 작업을 종료해야 하는지 판단이 가능해야 합니다. 따라서 현재 확보한 정보와 수행된 계산, 실행 상태를 바탕으로 다음 행동과 종료 여부를 결정하는 정책이 필요합니다.
- RQ2 (Memory & Later use) : 메모리는 정보를 얼마나 많이 저장하는가뿐 아니라, 어떤 원본을 유지하고 무엇을 요약할지, 수정된 정보가 언제부터 적용되는지도 중요합니다. 특히 과거에는 유효했던 정보와 현재 유효한 정보를 구분하고, 메모리의 변경이 기존 계획에 미치는 영향까지 추적할 수 있어야 하므로, 갱신된 메모리가 이후 작업에 어떻게 반영되어야 할지를 고려해야합니다.
- RQ3 (Dependency Preservation) : 검색에서는 답변을 뒷받침하는 근거 경로를, 실행에서는 실제 작업의 선행 조건을, 협업에서는 의사결정에 필요한 메시지 전달 경로를 유지해야 합니다. 문제가 발생했을 때에도 어떤 관계를 끝까지 보존해야 할지를 판단하여, 해당 노드에 의존하는 작업과 정보가 영향을 받는지 확인해야 합니다.
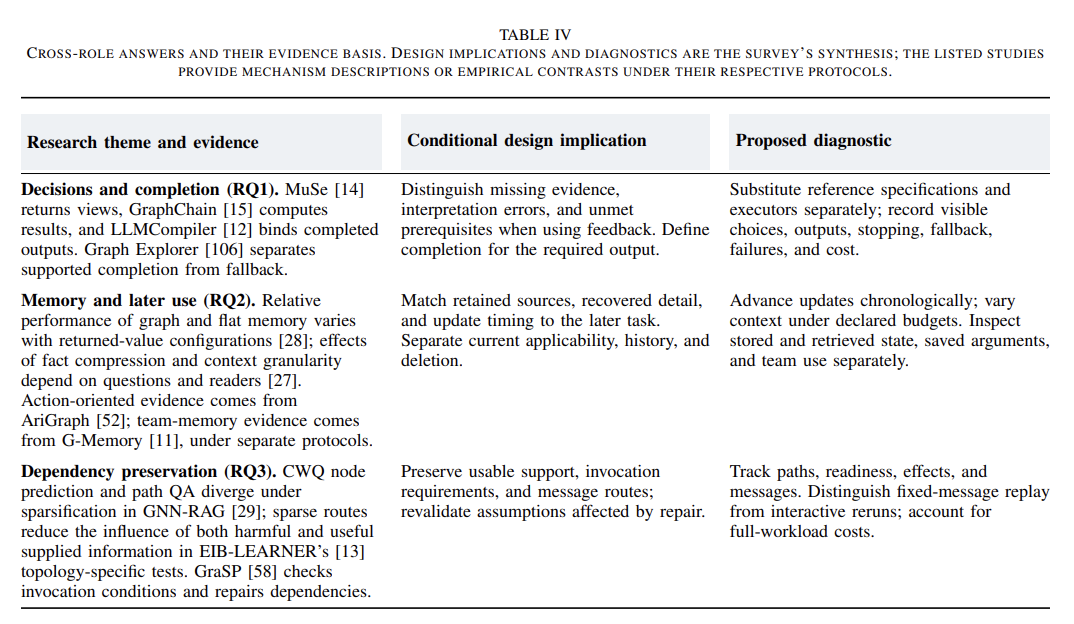
- 검색된 정보 자체가 달라진 결과인지, 동일한 정보를 사용하는 방식이 달라진 결과인지, 혹은 그래프 연산의 직접적인 기여인지 구별하기 위해 전체 파이프라인 비교, 동일한 상위 단계 결과를 사용하는 조건부 비교, 개별 구성 요소의 제거 및 교체 실험을 구분합니다. 또한 어떤 정보가 선택되었고, 어떤 작업이 실행 가능했으며, 수정된 정보가 실제로 다음 결정에 도달했는지와 함께 검색, 실행, 검증, 메모리 갱신에 들어간 비용까지 고려할 필요가 있습니다.
- 이번 논문은 폭넓은 관련 선행연구들을 공통된 관점에서 그래프 기능, 계산 책임을 비교 구분하고, 각 연산이 이후의 의사결정 과정에 미치는 영향을 평가해야 한다는 메세지를 전달하고 있습니다. 한편 다음 사례들이 그래프의 고유한 이점들을 입증하고 강조하는 것은 아니며, 비교 조건들을 명시하며 단순히 성능이 좋다 나쁘다를 구분하지도 않습니다.
- 그러면서 저자들은 저자들은 앞으로의 주요 연구 과제로 적응적인 탐색과 종료 판단, 지속적인 메모리 유지 및 갱신, 의존성에 기반한 실패 복구와 수정 정보의 전달을 제시합니다. 검색에서 얻은 사실이 메모리에 저장되고, 그 메모리가 실행 계획의 인자로 사용되며, 계획의 결과가 다른 에이전트에게 전달되는 전체 과정에서는 각 단계의 성공 여부뿐 아니라 단계 사이의 의존성이 올바르게 유지되는지가 중요해질 것이기 때문입니다.
- 즉, 지금의 AI 패러다임에서 그래프는 정보를 연결하고 검색을 빠르게 만드는 엔진 그 이상의, 여러 단계로 이루어진 시스템에서 무엇이 무엇에 의존하고, 어떤 변화가 이후 판단에 영향을 미치는지를 명시하는 수단으로 활용할 수 있습니다. 기존의 GraphRAG, Agentic Graph Memory 등을 독립적인 문제로 바라보는 데서 한 걸음 더 나아간 방향을 제시해주기에 한 번 읽어보시기를 추천드리고 싶습니다.
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184