10월 2주차 그래프 오마카세
[ADS]
1.GUG X Neo4j
국내 최초 neo4j 행사 밋업을 GUG 그리고 52g X GS 와 함께 11월 5일 목요일에 진행합니다.
국내에서는 GUG(Graph User Group)를 중심으로 오랫동안 Neo4j, Knowledge Graph, GraphRAG와 관련된 기술과 경험을 공유해왔는데요.이번에는 한 걸음 더 나아가 Neo4j 본사와 직접 협업하여 행사를 준비하게 되었습니다.
특히 Neo4j APAC의 Solution Engineer가 직접 한국을 찾아 세션을 진행합니다.그동안 국내에서 Neo4j를 사용하면서 Enterprise 기능이나 실제 구축 및 운영 방법, 아키텍처와 성능 이슈 등에 대해 궁금한 점이 있어도 Neo4j 엔지니어에게 직접 질문하고 답을 들을 수 있는 기회는 상대적으로 많지 않았다고 생각합니다.
이번 행사는 그런 거리를 조금 좁혀보려 합니다.Neo4j의 이야기를 일방적으로 듣는 자리를 넘어, Neo4j 엔지니어와 국내 개발자·연구자·현업 사용자들이 직접 만나 각자의 경험과 기술적 고민을 공유할 수 있는 자리를 준비하고 있습니다.
“Enterprise 환경에서는 실제로 어떻게 구성해야 할까?”
“운영 환경에서 성능 문제를 어떻게 접근해야 할까?”
“Knowledge Graph와 Ontology를 Neo4j 위에서 어떻게 설계하고 있을까?”
“GraphRAG와 AI Agent 시대에 Graph Database의 역할은 어떻게 달라지고 있을까?”
평소 Neo4j를 사용하며 궁금했던 부분이 있었다면, 이번에는 직접 질문하고 이야기해볼 수 있습니다.그리고 Neo4j의 세션만으로 끝내지 않으려고 합니다.
국내에서 Neo4j와 Graph 기술을 실제로 사용하고 있는 분들의 경험도 함께 공유하기 위해 CFP(Call for Proposals)를 오픈할 예정입니다.Neo4j를 활용한 프로젝트, Knowledge Graph, Ontology, GraphRAG, Graph Agent, Graph Database Engineering 등 다양한 경험을 기다리고 있습니다.
그리고 이 자리를 함께 채워주실 분들을 찾습니다.
📣 Call for Proposals — CFP Open
Neo4j를 실제 프로젝트에서 어떻게 활용했는지, Graph Database를 운영하면서 어떤 문제를 만났는지, Knowledge Graph·Ontology·GraphRAG·AI Agent와 Graph를 어떻게 연결하고 있는지 등 Graph와 관련된 다양한 경험을 기다리고 있습니다.
꼭 완성된 성공 사례일 필요는 없습니다.
“이 문제를 Graph로 풀어보니 이런 점이 어려웠다.”
“이런 구조로 설계했더니 예상과 다른 결과가 나왔다.”
“Agent와 Graph Database를 연결하면서 이런 문제를 발견했다.”
같은 엔지니어링 경험과 시행착오도 좋은 세션이 될 수 있다고 생각합니다.
🙌 Volunteer도 함께 모집합니다.
이번 행사를 단순히 ‘참석하는 행사’가 아니라 국내 Graph 생태계를 함께 만들어가는 자리로 만들고 싶습니다. 현장 운영, 참가자 안내, 세션 진행 지원 등 행사 준비와 운영을 함께해주실 자원봉사자분들도 찾고 있습니다. Graph와 Neo4j에 관심이 있고 커뮤니티 활동을 경험해보고 싶은 분이라면 환영합니다.
🎁 그리고 참석자분들을 위한 재미도 준비하고 있습니다.
Neo4j와 Graph 기술을 깊게 다루는 좋은 세션은 물론, 다양한 Swag / Goods와 경품도 준비할 예정입니다. Graph Database부터 Knowledge Graph, Ontology, GraphRAG, AI Agent까지.
Graph 기술을 실제로 만들고 사용하고 고민하는 사람들이 한자리에 모이는 행사를 만들어보겠습니다.
발표자로 경험을 공유하고 싶은 분,
행사를 함께 만들어보고 싶은 Volunteer,
그리고 Graph 기술이 궁금한 분들까지 모두 환영합니다.
행사 참여 링크 : https://luma.com/m89dvdk0
2.LoG Local Meetup
국내 그래프 연구자들을 연결할 LoG Local Meetup, 함께 만들어갈 공동 주최자를 모집합니다.
안녕하세요. 그래프 커뮤니티 GUG입니다.GUG는 Learning on Graphs Conference(LoG)의 취지에 맞춰, 국내 그래프 연구자들이 서로의 연구를 소개하고 토론할 수 있는 로컬 밋업 신청 및 준비를 하고 있습니다.
LoG는 그래프 머신러닝과 기하학 관련 연구를 다루는 국제 학회입니다. 로컬 밋업은 같은 지역의 연구자들이 직접 만나 연구 아이디어를 나누고, 새로운 협업의 접점을 만드는 자리입니다.만약 call for meetups 에선정된다면 이번 밋업에서는 국내 연구를 함께 소개하고, 진행 중인 연구의 고민과 아이디어까지 편하게 나눌 수 있는 프로그램을 만들고자 합니다.
*행사 링크 : https://lnkd.in/gJVehapJ
다음과 같은 분야에 관심 있는 분들을 환영합니다.
• 그래프 머신러닝: GNN, 그래프 표현 학습, 그래프 트랜스포머, 그래프 생성 모델
• 기하학 및 구조 학습: Geometric Deep Learning, 대칭성과 등변성, 3D·메시·포인트클라우드 학습
• 지식 표현과 추론: Knowledge Graph, 온톨로지, 지식 그래프 임베딩, 신경기호 추론
• 그래프와 LLM: GraphRAG, 그래프 기반 에이전트, 구조화된 지식을 활용한 검색과 추론
• 그래프 시스템: 그래프 데이터베이스, 대규모 그래프 처리, 분산 시스템, 하드웨어 가속
• 도메인 응용: 분자·신약·바이오, 추천 시스템, 금융, 교통, 과학·공학 데이터의 그래프 분석
위 분야에 직접 해당하지 않더라도, 데이터의 관계와 구조를 연구에 활용하고 계신다면 함께하실 수 있습니다. 대학원생, 대학·연구기관 연구자, 산업계 연구자와 엔지니어 모두 환영합니다!!
공동 주최자는 관심 분야에 맞춰 세션 주제 선정, 연사 추천, 포스터·라이트닝 토크 기획, 연구 토론 진행 등에 참여하게 됩니다. 모든 운영 업무를 맡기보다, 각자의 전문성과 가능한 범위에 맞춰 역할을 나누고자 합니다.
공간 대여와 행사 운영에 필요한 비용은 GUG가 선정된 오픈소스 지원사업을 통해 NIPA와 OpenUP의 지원을 받아 부담합니다. 함께하시는 분들이 연구 콘텐츠와 교류 프로그램에 집중할 수 있도록 준비하겠습니다.
다른 연구실과 산업계의 동료를 만나고, 자신의 연구 분야를 더 넓은 그래프 커뮤니티와 연결하고 싶은 분들의 참여를 기다립니다. LoG 논문 채택 여부나 행사 운영 경험에 관계없이 관심 있는 분들은 연락 주세요.
참여를 희망하시면 메시지로 소속, 관심 연구 분야, 함께 기획하고 싶은 주제를 간단히 보내주세요. 국내 그래프 연구가 서로 연결되고, 다음 협업으로 이어지는 자리를 함께 만들어가면 좋겠습니다.
문의 메일 : Graphusergroup@gmail.com
PLUREL: Synthetic Data unlocks Scaling Laws for Relational Foundation Models
 Vignesh Kothapalli
Keywords
- Relational Foundation Model
- Synthetic Data
- Scaling Law
- Foundation Model의 발전을 이야기할 때 빠지지 않는 것이 대규모 사전학습 데이터입니다. ChatGPT 같은 언어 모델은 아주 많은 문장을 먼저 학습한 뒤 번역, 요약, 질의응답처럼 서로 다른 작업을 수행합니다. 이미지 모델 역시 수많은 이미지를 먼저 학습한 뒤 다양한 비전 태스크에 활용됩니다.
- 그런데 실제 기업 데이터의 상당 부분을 차지하는 관계형 데이터베이스에서는 이 전략을 그대로 적용하기가 어렵습니다. 실제 데이터베이스에서 중요한 정보는 보통 하나의 거대한 표에 들어있지 않고, 여러 개의 표로 나뉘어 있으며 서로 ID를 통해 연결되어 있기 때문입니다. 즉, 관계형 데이터베이스를 이해하려면 이 데이터가 다른 데이터와 어떻게 연결되어 있는지를 함께 이해해야 합니다.
- 최근에는 이런 데이터를 여러 작업에 공통으로 사용할 수 있는 Relational Foundation Model(RFM)도 연구되고 있습니다. 하지만 RFM 연구 계보에 현실적인 문제가 하나 있습니다. 바로 이 모델을 사전학습할 데이터베이스가 없다는 것입니다.
- 실제 관계형 데이터베이스에는 고객 정보나 금융 기록, 기업 내부 활동처럼 외부에 공개하기 어려운 정보가 많기 때문에 대부분 기업 내부에 있고, 텍스트나 이미지처럼 다양한 공개 데이터베이스를 자유롭게 대규모로 수집하기 어렵습니다. 기존 Relational Foundation Model들도 이러한 이유로 소수의 공개 데이터베이스에 의존해왔습니다.
- ICML 2026에서 발표된 PLUREL은 서로 다른 구조와 데이터를 가진 새로운 가상 데이터베이스를 처음부터 계속 만들어내는 방법을 제안합니다. 그리고 그렇게 만들어진 데이터베이스를 많이 학습했을 때 Relational Foundation Model의 성능이 어떻게 변하는지를 살펴봅니다.
- Synthetic data generation(SDG) 자체는 새로운 아이디어가 아닙니다. Structural Causal Model이나 tree-based generator를 이용해 다양한 synthetic table을 만들고, 이를 Tabular Foundation Model의 사전학습 데이터로 사용하는 연구가 이미 존재합니다.
- 하지만 관계형 데이터베이스에는 표와 표 사이의 연결정보가 추가적으로 필요합니다. 관계형 데이터의 SDG는 각 표의 숫자를 그럴듯하게 만드는 것만으로는 부족하며, 어떤 표들이 연결될지, 그리고 그 안에서 어떤 행들이 실제로 서로 연결될지까지 만들어야 합니다. 논문에서도 이러한 Primary–Foreign Key 연결을 관계형 데이터의 핵심 요소로 보고 있습니다.
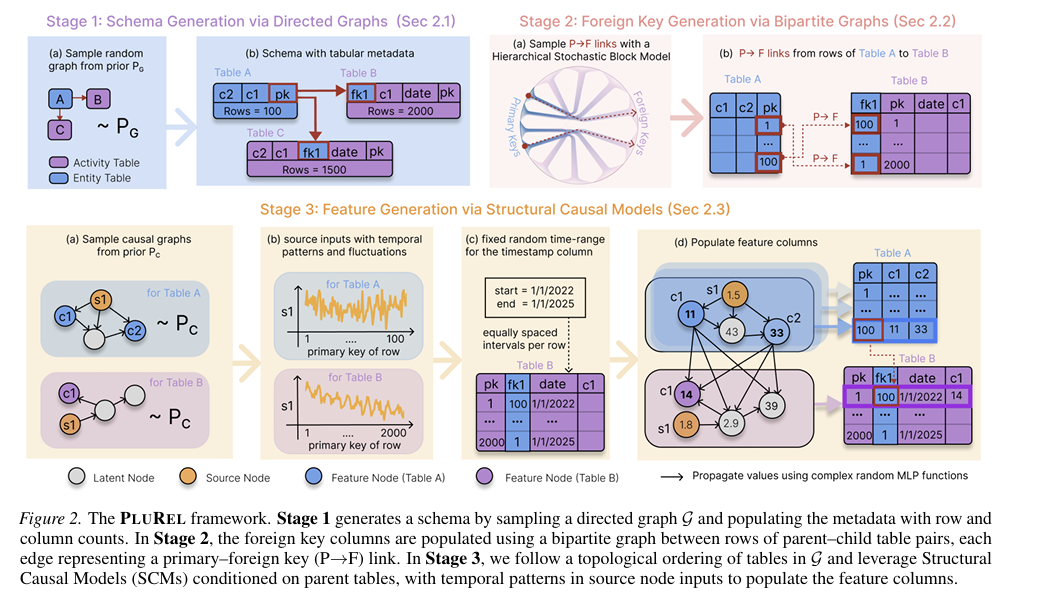
- 그래서 PLUREL은 데이터베이스 하나를 세 단계(Schema structure Row connectivity, Feature distribution)로 나누어 생성합니다. 그리고 재미있게도 세 단계 모두 그래프가 등장합니다.
Stage 1 : 데이터베이스의 뼈대 만들기
- 가장 먼저 결정해야 할 것은 어떤 표들이 존재하고, 어떤 표와 연결되는가입니다. PLUREL은 이 관계를 그래프(노드: 각 table, 엣지: table 사이의 연결)로 표현합니다.
- PLUREL은 매번 같은 그래프를 만들지 않습니다. 어떤 데이터베이스에서는 특정 table이 여러 table과 연결된 중심 역할을 하게 만들고, 어떤 경우에는 나무처럼 계층적인 구조를 만들며, 또 다른 경우에는 몇 개의 table이 서로 가까이 뭉쳐 있는 구조를 만듭니다.
- 매번 다른 관계 구조를 가진 database를 만들어낼 수 있다는 것이 중요한 포인트입니다. 이를 위해 서로 다른 종류의 random graph를 사용합니다.
Stage 2 : 어떤 데이터가 어떤 데이터와 연결될지 정하기
- Stage 2가 중요한 이유는 현실의 관계형 데이터가 완전히 random하게 연결되어 있지 않기 때문입니다. 예를 들어 특정 아이템이 특정 대상에 집중될 수도 있고, 이것이 많은 transaction에서 반복해서 참조될 수도 있습니다.
- 즉, schema graph만 만들어서는 실제 database가 완성되지 않습니다. PLUREL은 이 문제를 bipartite graph generation 문제로 바라봅니다. 두 table의 row들을 여러 개의 hierarchical block으로 나누고, 특정 그룹끼리 더 자주 연결되도록 만듭니다. 논문에서는 이를 Hierarchical Stochastic Block Model(HSBM)을 이용해 구현합니다.
- 모든 parent row를 동일한 확률로 선택하는 단순한 설정도 PLUREL 안에서는 가능하지만, hierarchical block structure를 이용하면 일부 row 집단 사이의 연결을 더 강하게 만들어 row-level information locality를 조절할 수 있습니다.
- 여기서의 핵심은 foreign key를 완전히 무작위로 찍지 않고, 현실의 데이터처럼 연결이 일부 지역에 몰릴 수 있도록 만드는 것입니다.
Stage 3 : 실제 테이블 값을 채워넣기
- 데이터 뼈대와 그 연결을 구축했으니, 실제로 해당 table에 들어갈 값을 만들어야 합니다. 여기에서 PLUREL은 Structural Causal Model (SCM)이라는 방법을 사용합니다. SCM 역시 causal graph 형태이며, node는 변수, directed edge는 변수 사이의 dependency를 나타냅니다.
- SCM은 값들을 완전히 독립적으로 랜덤하게 생성하는 것이 아니라, '이 값은 어떤 다른 값들의 영향을 받아 생성되었는가' 라는 관계를 먼저 만들고 해당 값을 생성하는 방식입니다. 여기에서 중요한 것은 다른 table의 정보도 함께 사용한다는 점이며, 시간에 따른 변화도 어느 정도 포함됩니다.
- 위의 단계들을 하나로 종합하면 Schema graph가 table의 관계를 정하고, Bipartite graph가 row의 관계를 정하고, SCM이 그 관계 위에서 feature 값을 생성합니다. 구조와 데이터 값이 서로 따로 생성되는 것이 아니며, 하나의 작은 데이터베이스를 통째로 만드는 개념으로 이해하는 것이 직관적일 것 같습니다.
- 여기까지라면 PLUREL은 흥미로운 synthetic database generator입니다. 그렇다면 모델에게 어떤 방식으로 데이터를 늘려주는 것이 좋을까요? 이 중요한 질문이 바로 논문의 제목에 Scaling laws가 들어간 이유입니다.
- 해당 질문에 대해 저자들은 두 가지 축(Size, Diversity)을 따로 비교하여 관계형 Foundation Model에서도 이런 차이가 존재하는지를 확인합니다.
- 데이터 양을 늘리는 것 (Size) : 하나의 데이터베이스에서 더 많은 데이터를 꺼내 학습할 수 있습니다.
- 데이터베이스의 종류 자체를 늘리는 것 (Diversity) : 몇 개의 데이터베이스만 반복해서 보는 대신, 서로 다른 구조를 가진 것들까지 (최대 1,024개) 보여줍니다.
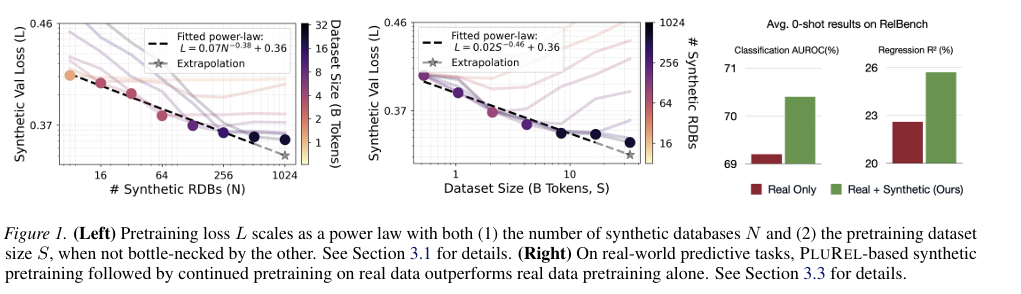
- 저자들은 PLUREL을 이용해 다양한 synthetic database를 만든 뒤 Relational Transformer(RT)를 billions of tokens 규모로 pretraining합니다. 위의 Figure 1은 꽤 흥미로운 결과를 보여줍니다.
- Synthetic database의 종류가 충분히 많을 때는 학습 데이터의 양을 늘릴수록 loss가 일정한 패턴으로 감소합니다. 반대로 학습 데이터의 양이 충분할 때는 서로 다른 database의 수를 늘리는 것 역시 loss를 줄이는 방향으로 작동했습니다. 저자들은 이러한 관계가 각각 power-law 형태와 잘 맞는다고 보고합니다.
- 하지만 무조건 한쪽만 늘리면 되는 것은 아니었습니다. 여기에서 token 수를 고정한 채 database 종류만 계속 늘리면 각각의 DB를 충분히 학습하지 못해 underfitting할 수 있고, 반대로 database 종류가 적은 상태에서 token 수만 계속 늘리면 제한된 구조를 반복해서 보면서 overfitting할 수 있습니다.
- 논문에서 개별 scaling curve가 일부 U-shape를 보이는 이유로 설명합니다. 다만 모든 curve가 단조 감소하는 것은 아니므로, 두 축(size, diversity) 가운데 하나만 키우면 bottleneck이 생길 수 있다는 점을 함께 짚어주고 있습니다. 따라서 저자들은 많이 보여주는 것보다 다양하게 많이 보여주는 것, 즉 diversity와 size를 함께 증가시키는 것이 중요하다고 해석합니다.
- Synthetic validation loss가 좋아졌다는 것만으로는 충분하지 않습니다. 저희들이 관심있는 결과는 바로 학습 과정에서 한 번도 보지 않은 real-world relational database에서도 같은 효과가 나타나는가입니다.
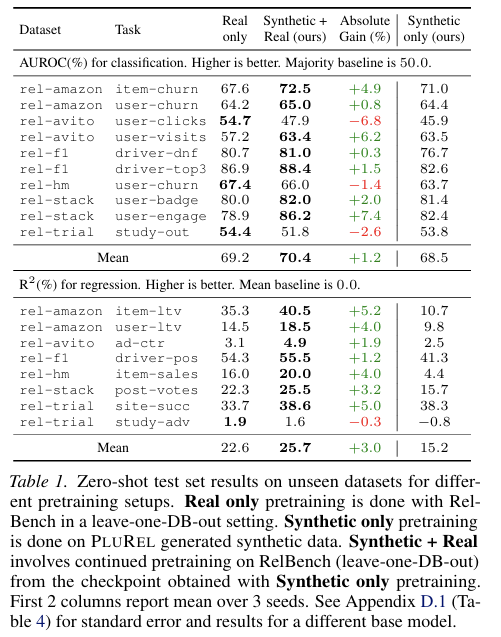
- 저자들은 RelBench의 6개 데이터베이스(rel-amazon, rel-avito, rel-f1, rel-hm, rel-stack, rel-trial)를 사용하고, 10개의 binary classification task와 8개의 regression task에서 zero-shot 성능을 평가합니다.
- 해당 실험에서도 앞서 살펴본 패턴이 반복됩니다. synthetic DB가 8개, 16개, 32개 정도로 적은 상태에서는 token 수를 증가시켜도 실제 RelBench validation loss가 오히려 악화되기도 합니다. 반대로 synthetic database의 diversity가 충분히 증가하면 dataset size를 늘렸을 때 실제 데이터에서도 성능 개선이 나타납니다.
- 하지만 PLUREL로 만든 synthetic data만 사용한 모델이 실제 데이터에서도 가장 좋은 성능을 보인 것은 아닙니다. 위의 Table 1에서는 세 가지 Pretraining 방법을 비교합니다.
- Real only – 실제 RelBench 데이터만 사용
- Synthetic only – PLUREL 데이터만 사용
- Synthetic + Real – PLUREL로 pretrain 후 실제 데이터로 continuous pretrain
- 가장 좋은 결과를 보인 것은 세 번째 방법이었습니다. (AUROC 69.2 –> 70.4 / Regression R^2 22.6 –> 25.7 개선) 개별 task에서는 최대 AUROC +7.4 , R^2 +5.2 pp의 향상이 관찰됐습니다. 특히 regression에서는 8개 task 중 7개에서 Real-only보다 높은 결과를 보였습니다.
- 반대로 Synthetic-only 모델은 많은 task에서 Real-only보다 낮았습니다. 즉, 합성 데이터로 실제 데이터를 대체할 수 있다는 것은 맞지 않으며, 많은 종류의 합성 데이터를 보게하는 것이 실제 데이터에 적응하기 좋다는 결과가 올바른 해석입니다.
- 일반적으로 Foundation Model의 발전을 생각하면 흔히 얼마나 많은 데이터를 학습했는가를 먼저 떠올립니다. 하지만 다음 저자들은 관계형 데이터에서 '얼마나 서로 다른 구조의 데이터를 학습시켜 보게했느냐?' 라는 추가 질문을 던졌습니다.
- 하나의 데이터베이스에서 320억 개의 token을 보는 것과, 서로 다른 구조를 가진 수백 개의 database를 경험하는 것은 같은 학습이 아닐 수 있습니다. 실제로 논문의 실험에서 database diversity와 전체 data size가 서로 다른 두 scaling axis로 나타났습니다. 이 부분이 개인적으로 가장 흥미로웠던 결과였습니다.
- 저자들의 후속 연구로 model size까지 함께 키웠을 때 같은 scaling relation이 유지되는지를 확인해본다고 명시되어있습니다. 즉, 이번 결과는 RT라는 하나의 모델 계열에서 확인되었으며 일반화된 결과 및 그 해석은 어려울 것 같습니다. 또 현재 PLUREL은 주로 숫자와 categorical data를 생성하며, 현재 schema는 DAG를 기본으로 하기 때문에 자기 자신을 다시 참조하는 table과 같은 구조는 지원하지 않습니다.
- PLUREL은 어떤 table이 존재하고, 어떤 row들이 연결되며, 그 관계를 따라 데이터가 어떻게 만들어질지를 그래프 구조로 설계합니다. 이번 논문에서 그래프는 데이터를 분석하는 도구를 넘어, 모델이 학습할 다양한 데이터 세계를 만들어내는 설계 도구로 한 단계 확장시켜 보여주었다고 생각합니다.
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184