2026년 10월 3주차 그래프 오마카세
Opensource – LadybugDB v0.21.0 Release
LadybugDB v0.21.0 Release
LadybugDB v0.21.0 brings correctness, stability and performance improvements with GraphLake, SQL pushdown, and lakehouse integrations.
 Ladybug Inc.
GitHub - LadybugDB/ladybug: LadybugDB a graph database
LadybugDB a graph database. Contribute to LadybugDB/ladybug development by creating an account on GitHub.
- LadybugDB는 2025년 10월 아카이브된 Kuzu를 포크하여 이어받은 오픈소스 임베디드 그래프 데이터베이스입니다. Kuzu에서 발전시켜 온 그래프 질의 처리 기술을 기반으로 외부 데이터 소스와의 연동을 확장하고 있습니다.
- 지난 9월 30일 공개된 v0.21.0 릴리스에서는 SQL Pushdown, 외부 데이터 카탈로그, DuckLake 연동을 개선하고, 이를 GraphLake라는 방향으로 연결했습니다. 노트를 읽어보면 GraphLake는 그래프 데이터를 어떻게 저장할 것인지뿐 아니라, 기존 데이터가 있는 곳에서 그래프 질의를 어떻게 실행할 것인지라는 질문으로 이어집니다.
💡
기존 SQL 데이터를 옮기지 않고도 그래프 형태로 질의할 수는 없을까?
- 최근 그래프 기술은 GraphRAG, 지식그래프, 데이터 분석 등 다양한 분야로 확장되고 있습니다. 그런데 실제 시스템에서 그래프를 활용하려고 하면 이미 존재하는 데이터를 그래프 데이터베이스로 다시 옮겨야 하는 번거로움이 존재합니다.
- 이번 주 오마카세는 다음 질문에 대한 해답을 LadybugDB의 v0.21.0의 SQL Pushdown과 Icebug의 작동 방식, 그리고 이들이 GraphLake라는 구상에서 각자 어떤 역할을 하는지 살펴보겠습니다.
GraphLake를 구성하는 세 가지 아이디어
- SQL pushdown – 기존 SQL 데이터베이스를 그래프로 해석
- LadybugDB는 외부 데이터베이스를 연결한 뒤, 지원되는 Cypher 패턴을 SQL의 JOIN이나 집계 연산으로 변환하여 원본 데이터베이스에서 실행할 수 있습니다.
- 여기서 중요한 것은 질의를 작성하는 언어와 실제 데이터를 처리하는 엔진이 다를 수 있다는 점입니다. 사용자는 그래프의 연결 패턴으로 질의를 작성하지만, 실행 가능한 부분은 SQL로 변환되어 원본 시스템에서 처리됩니다.
- 다만 모든 SQL 테이블이 자동으로 그래프가 되는 것은 아닙니다. PostgreSQL 등의 연동에서는
node_,rel_접두사와 외래 키 관계를 활용하는 규칙이 있으며, DuckLake는 PK/FK 제약을 저장하지 않아 위 예제처럼 관계를 명시적으로 선언해야 합니다. 또한 SQL Pushdown 최적화는 관련 노드, 관계 테이블이 동일한 외부 데이터베이스에 존재하고 지원되는 패턴을 사용할 때 적용됩니다.- PostgreSQL 확장인
pg_ladybug의ladybug.pushed_sql함수를 활용해 어떤 SQL이 생성되었는지 확인하고, 예상한 최적화가 적용되었는지 살펴볼 수 있습니다.
- PostgreSQL 확장인
- 지원하지 않는 패턴의 실행 방식은 연동 경로마다 다릅니다. PostgreSQL 확장은 직접 실행으로 전환할 수 있지만, DuckDB의 일부 외부 관계 테이블 테스트에서는 Pushdown되지 않는 로컬 탐색이 오류를 발생시킨다고 명시되어 있습니다.
- 여러 단계의 관계를 탐색하는 재귀 패턴을 SQL로 변환
- 이번 업데이트에서는 여러 단계의 관계를 탐색하는 일부 재귀 패턴도 SQL의
WITH RECURSIVE로 변환할 수 있습니다. 그로부터 SQL Pushdown의 활용 범위를 크게 넓혔습니다. - 물론 모든 재귀 탐색을 SQL로 변환할 수 있는 것은 아닙니다. 현재 최적화는 유한한 탐색 상한, WALK 의미론, 단일 방향 관계 등의 조건을 요구하며, 경로 객체를 출력하거나 중간 노드에 조건을 부여하는 일부 패턴은 제외됩니다.
- 공식 테스트에서는 1~3단계의 연결 경로를 탐색하는 패턴 예제를 보여줍니다. 같은 정점에 도달하더라도 서로 다른 경로가 존재하면 중복 결과가 나타날 수 있으므로, 고유한 도착 정점만 필요하다면 별도로 중복을 제거해야 합니다.
- 즉, SQL 경로에서도 다단계 탐색이 가능하지만, 전용 그래프 저장 구조와 SQL 기반 탐색의 표현 범위 및 성능은 여전히 구분해서 평가해야 합니다.
- LadyBugDB Icebug – 관계 탐색에 최적화된 그래프 형태로 저장
Ladybug - Graph Database
Documentation for Ladybug, an open source, embedded graph database

- 반대로 같은 그래프를 반복적으로 분석한다면 관계 탐색에 최적화된 형태로 미리 저장하는 편이 유리할 수도 있습니다. LadybugDB는 이를 위해 Icebug라는 그래프 전용 저장 형식을 제공합니다.
- Icebug Format v1은 Icebug-Disk, Memory라는 이름의 두 형태로 나뉩니다. 두 방식 모두 CSR(Compressed Sparse Row) 구조를 활용합니다.
- Disk : Parquet 기반 저장 형식으로, 객체 저장소에 있는 필요한 데이터 범위를 지연 로딩할 수 있습니다.
- Memory : Arrow 기반 인메모리 형식으로, 현재 변환 유틸리티는 Python에서 제공됩니다.
- SQL Pushdown이 기존 SQL 엔진을 활용하는 방식이라면, Icebug는 그래프 탐색에 맞춰 저장 구조를 준비하는 방식입니다. 공식 v0.17.0 발표에서도 Icebug를 확장 가능한 분석 워크로드용 권장 저장 형식으로 소개하면서, 사용하기 편리한 단일 파일 네이티브 데이터베이스 역시 계속 지원한다고 설명합니다. 다만 Icebug 파일을 처음 만드는 변환 과정은 필요할 수 있으며, 준비된 Icebug 데이터는 LadybugDB의 네이티브 저장소에 다시 적재하지 않고 질의할 수 있습니다.
What is GraphLake ?
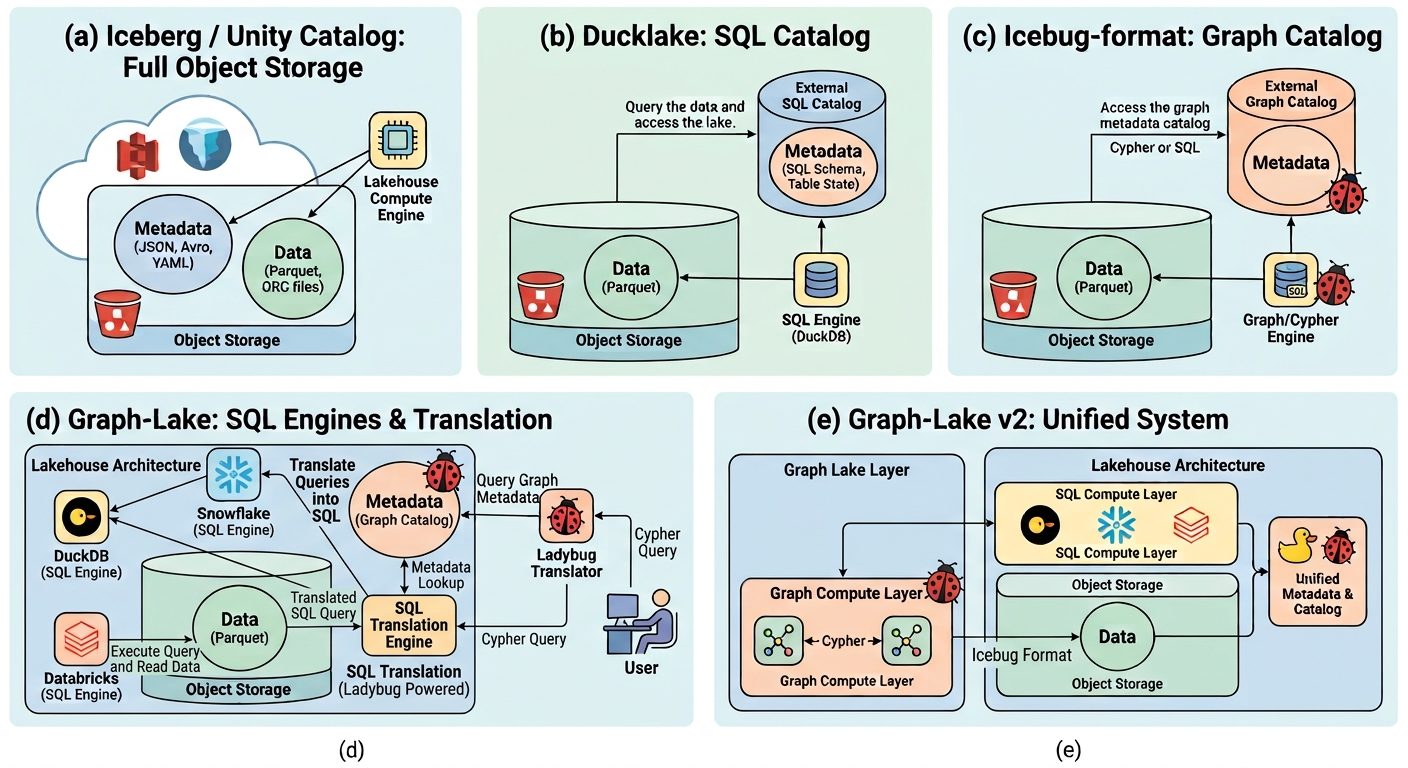
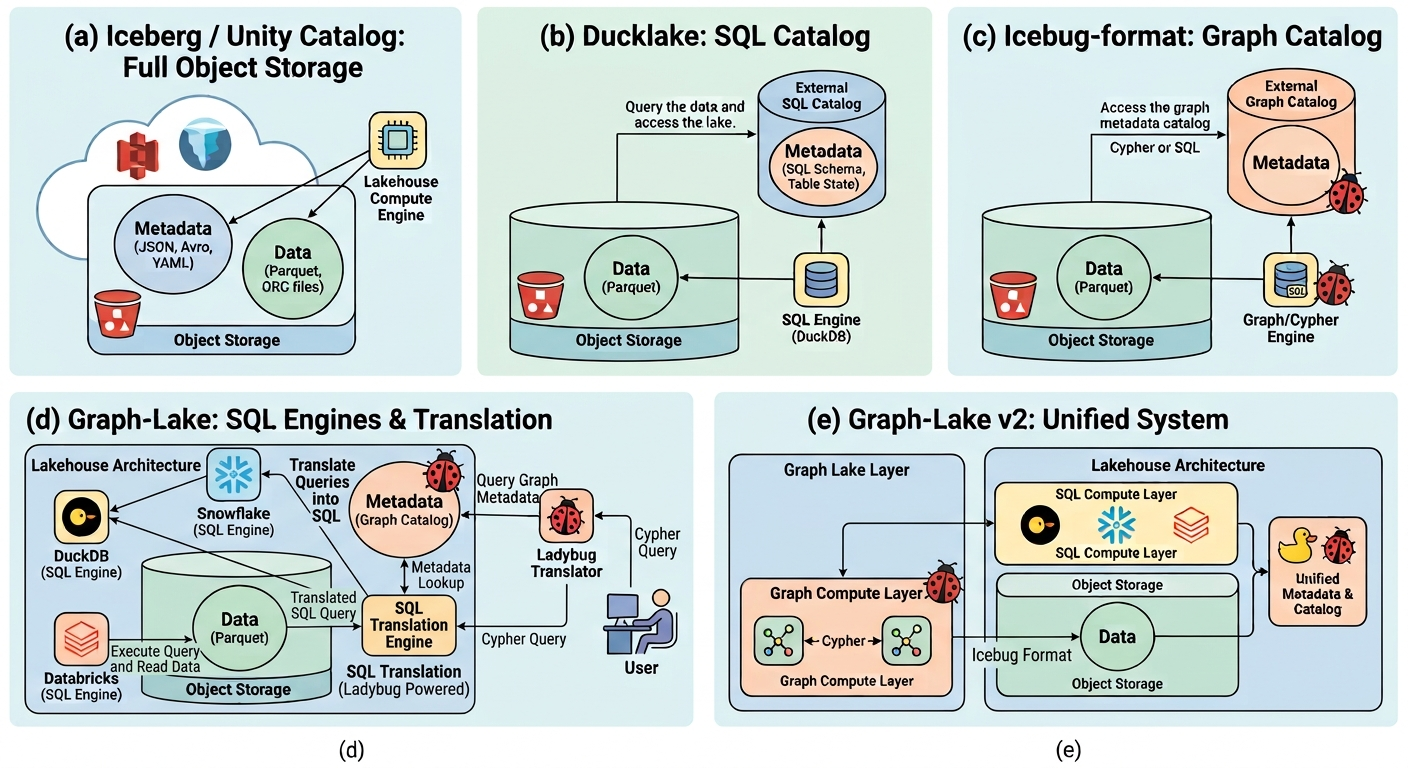
- 이번 업데이트에서 소개한 GraphLake의 기본 구상은 Iceberg 테이블과 Icebug-Disk를 결합하는 것입니다. 여기서 주목할 부분은 그래프 데이터뿐 아니라 메타데이터를 관리하는 방식입니다.
- Iceberg는 객체 저장소의 메타데이터 파일을 활용해 테이블 상태를 관리합니다. 반면 DuckLake는 SQL 데이터베이스를 카탈로그로 활용하는 접근을 제시합니다. 이러한 발상에서 영감을 받아, LadybugDB는 객체 저장소의 JSON 메타데이터 파일 대신 SQL 또는 Cypher 데이터베이스의 카탈로그를 활용하는 방향을 소개합니다. 현재 DuckLake 연동과 Icebug 기반 질의 등 개별 기능은 제공되고 있습니다.
- 아직 제시한 최종 구조 전체가 완벽히 구현되었다고 단정할 근거는 충분하지 않습니다만 실제 그래프 데이터의 저장, 메타데이터 관리, 질의 실행을 분리하여 구성하려는 개발팀의 아키텍처적 방향성으로 해석할 수 있습니다. 즉, 현재 제공되는 기술과 앞으로 지향하는 기술 구조를 병합하고자 하는 구상 아이디어로 이해하는 것이 좋습니다.
- 이번 릴리즈 노트에서 흥미로웠던 부분은 그래프를 활용하는 방식이 하나로 고정된 것이 아닌 기존 SQL 데이터를 그대로 사용하거나(SQL Pushdown), 그래프 전용 파일을 만들어서 반복 분석(Icebug-Disk) 또는 Arrow 기반 파이프라인 안에서 메모리 분석(Icebug-Memory)을 각 기술의 설계 특성에 맞추어 선택할 수 있는 여러 실행 경로를 제공한다는 점입니다.
- 실제로 비공식 벤치마크에서 질의 성능 개선을 보고하지만 세 아이디어를 동일 조건으로 비교한 결과는 아니므로 실제 환경에서 각 방식의 선택에서는 질의 패턴, 저장 비용 등과 실행 환경을 폭넓게 고려해야 합니다.
- 오마카세 구독자분들께 전달해드릴 수 있는 메세지는 그래프 데이터베이스를 또다른 관점에서 바라보는 흥미로운 인사이트가 녹아있다는 것입니다. 그래프를 사용하기 위해 데이터를 어떻게 옮길 것인지보다, 기존 데이터는 유지하면서 이미 존재하는 데이터의 연결 관계를 그래프로 어떻게 효율적으로 표현하고 실행할 수 있을지를 선택할 수 있게 되는 것입니다.
- GraphLake가 최종적인 해답이 될수는 없겠지만 차후 그래프DB 분석의 경계에서 업데이트 내용을 충분히 지켜볼 만한 부분이라고 생각이 됩니다.
[Contact Info]
Gmail: jhbae1184@akane.waseda.jp
Twitter (X): @jhbae1184